核心摘要:Rust 驱动的开源分块器
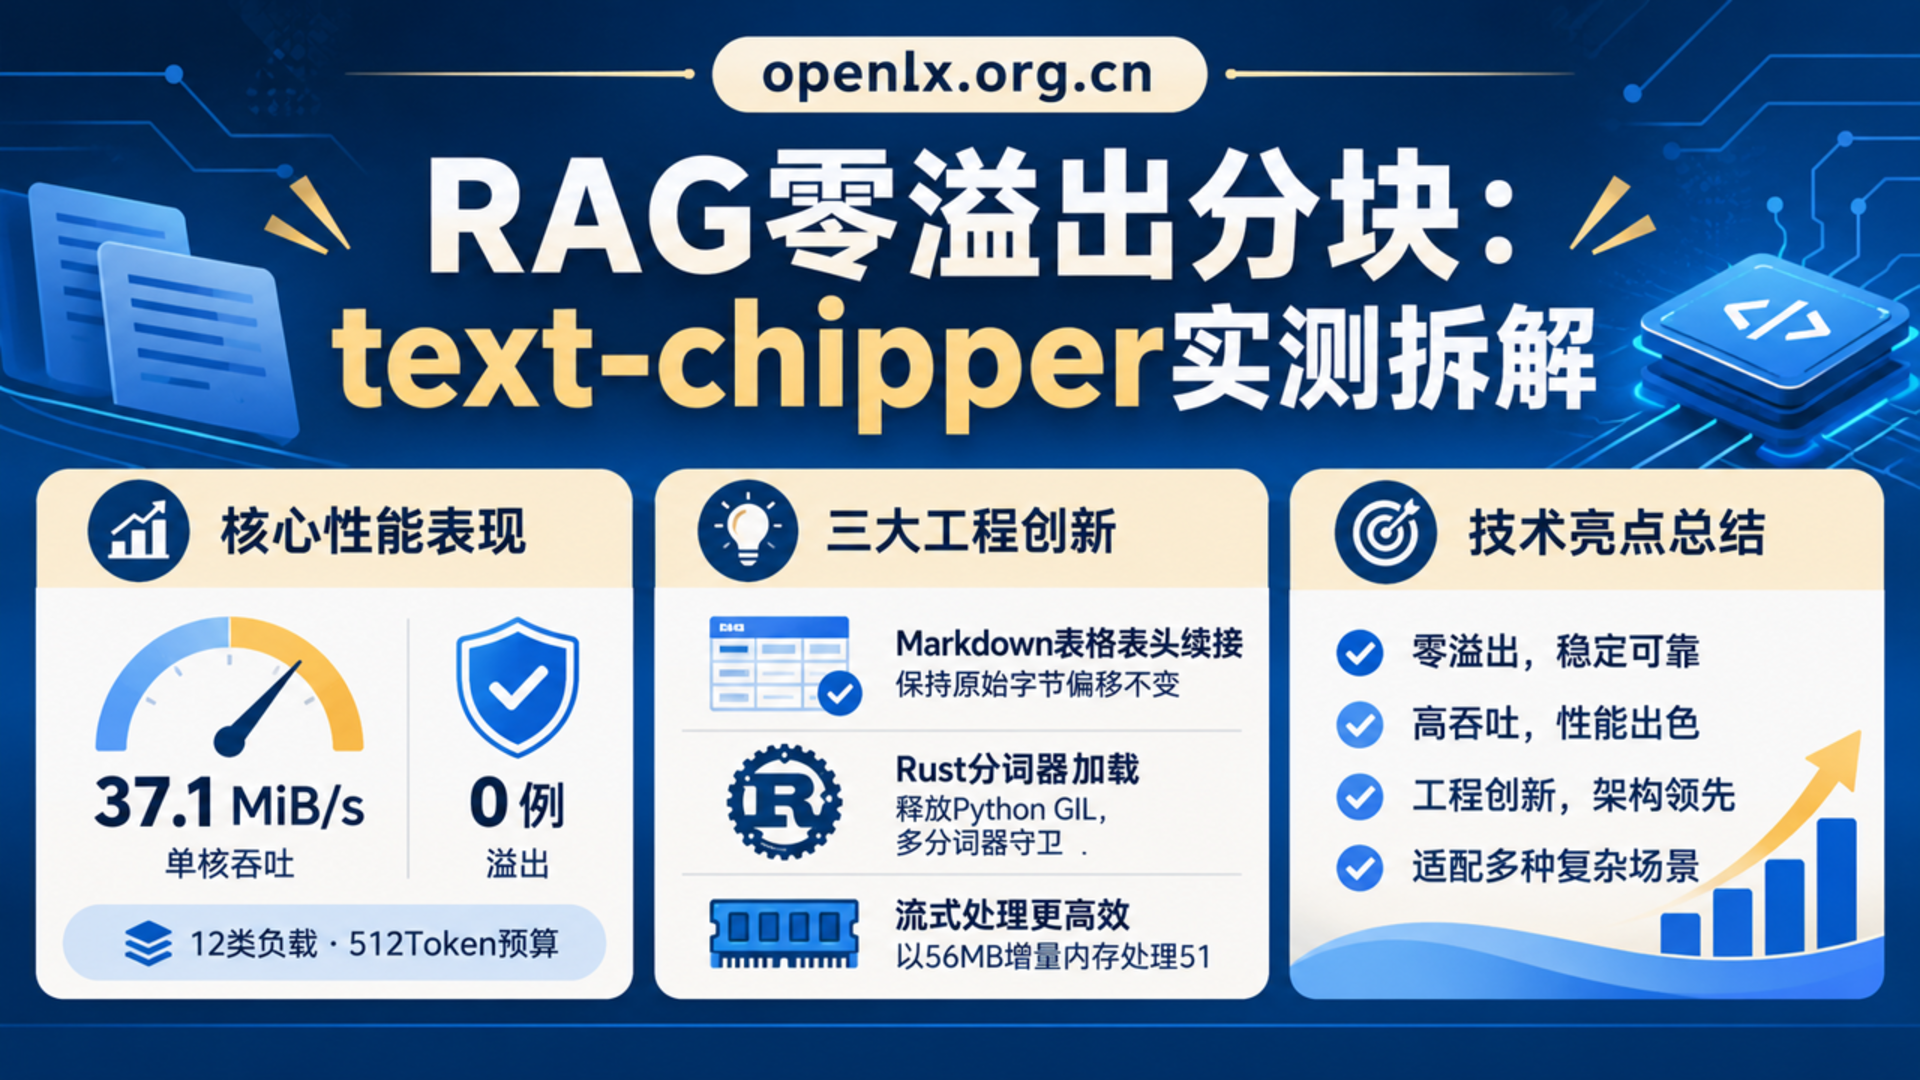
text-chipperv1.1.0 在 12 类基准下跑出 37.1 MiB/s 单核吞吐与 0 例 512 Token 溢出,支持保留原始字节偏移的 Markdown 表格表头续接与零 GIL 原生分词器加载,解决 RAG 预处理中速度与结构完整性难以兼得的工程痛点。
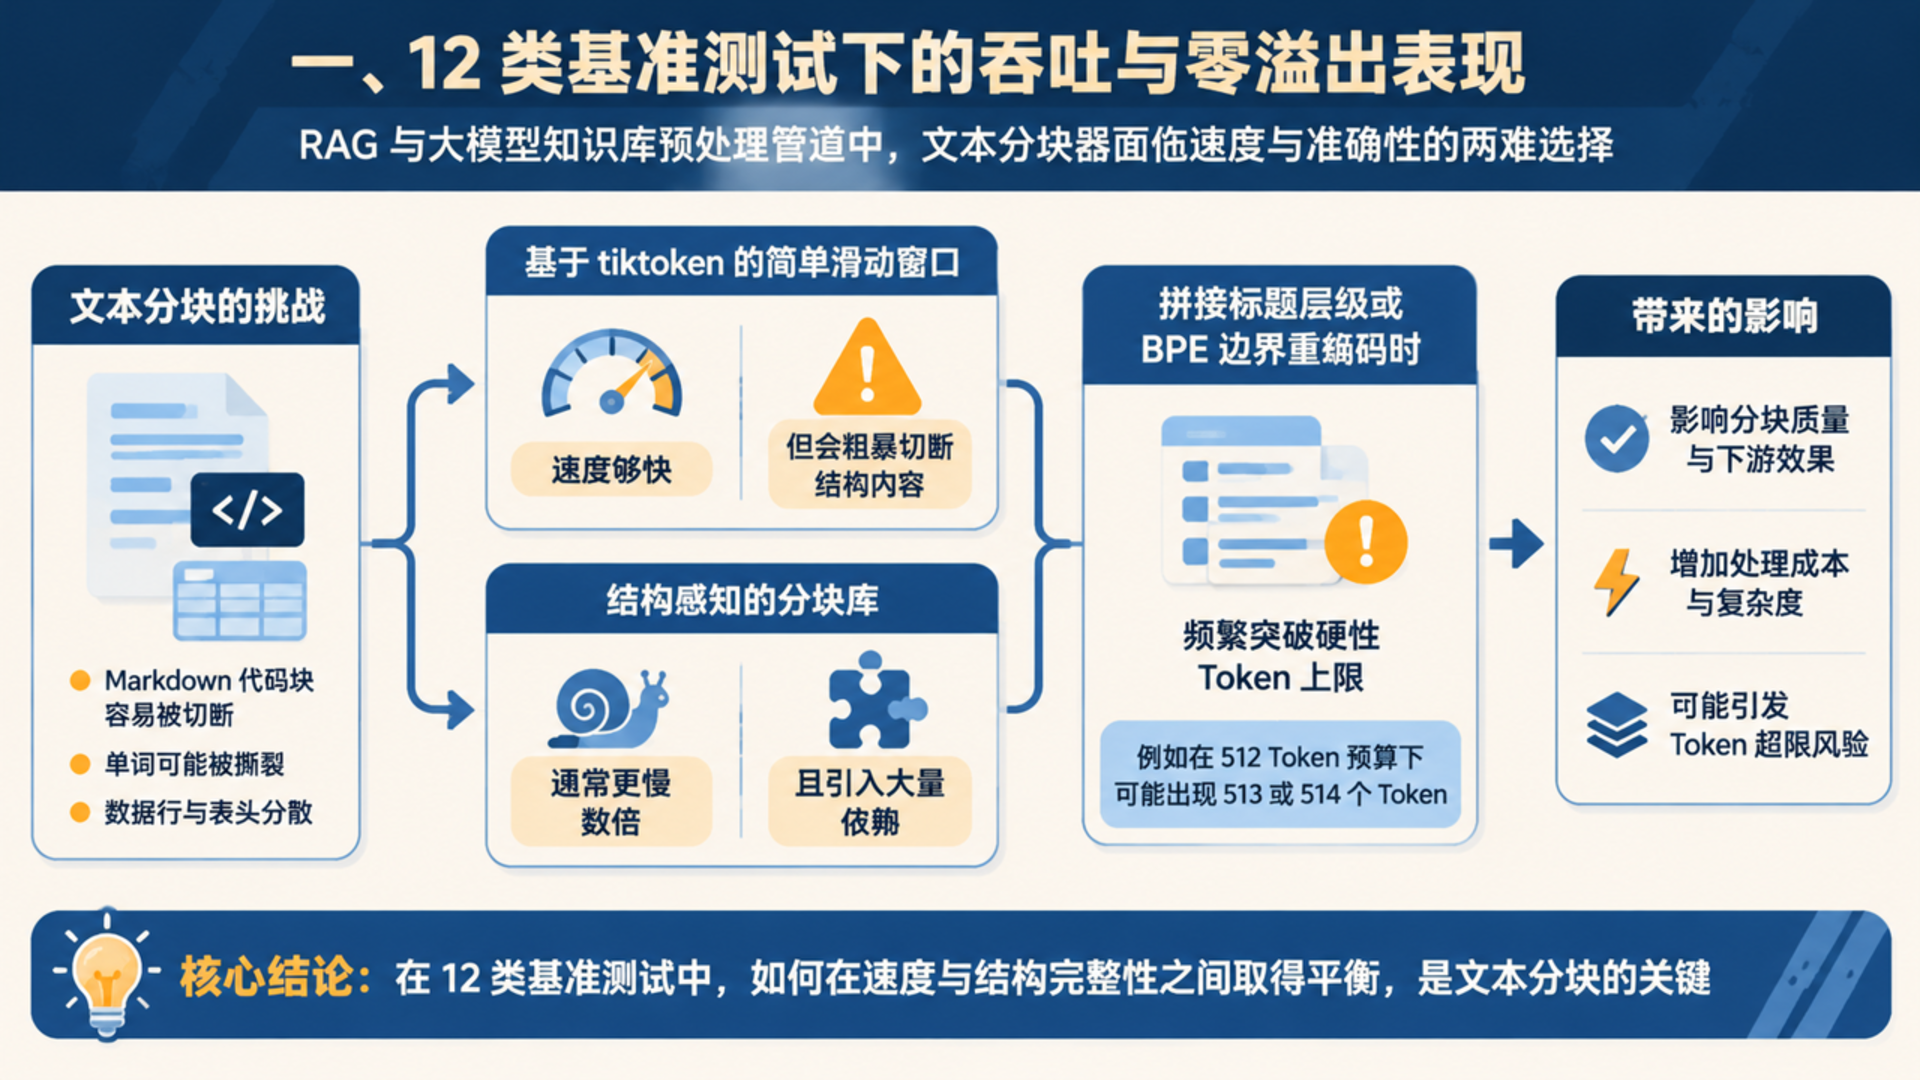
在 RAG(检索增强生成)与大模型知识库预处理管道中,文本分块器长期处于两难状态:基于 tiktoken 的简单滑动窗口速度够快,却会粗暴切断 Markdown 代码块、撕裂单词,甚至把数据行与表头拆散;而强调结构感知的分块库往往慢上数倍、引入大量依赖,且在拼接标题层级或 BPE 边界重编码时频繁突破硬性 Token 上限(例如在 512 Token 预算下吐出 513 或 514 个 Token)。开发者 Omer Cihangiroglu 于 2026 年 11 月 21 日在 DEV Community 发布了 text-chipper v1.1.0(Apache-2.0 开源协议,提供 PyPI 与 Rust crate)的工程架构与基准拆解。
需要说明来源边界:本文引用的吞吐量、内存占用与溢出计数均来自作者公开博文中的自测基准(硬件为单核对比测试,严格限制 512 Token、cl100k_base、overlap=0),实际生产吞吐受 CPU 架构与语料结构影响,建议在各自语料库上复核。
一、12 类基准测试下的吞吐与零溢出表现
根据作者公布的 12 项工作负载(涵盖合成散文、Markdown、代码、PubMed、金融文本、维基百科、对话日志与压力用例)单核几何平均测试结果,text-chipper 在速度与硬性边界约束上呈现出显著优势:
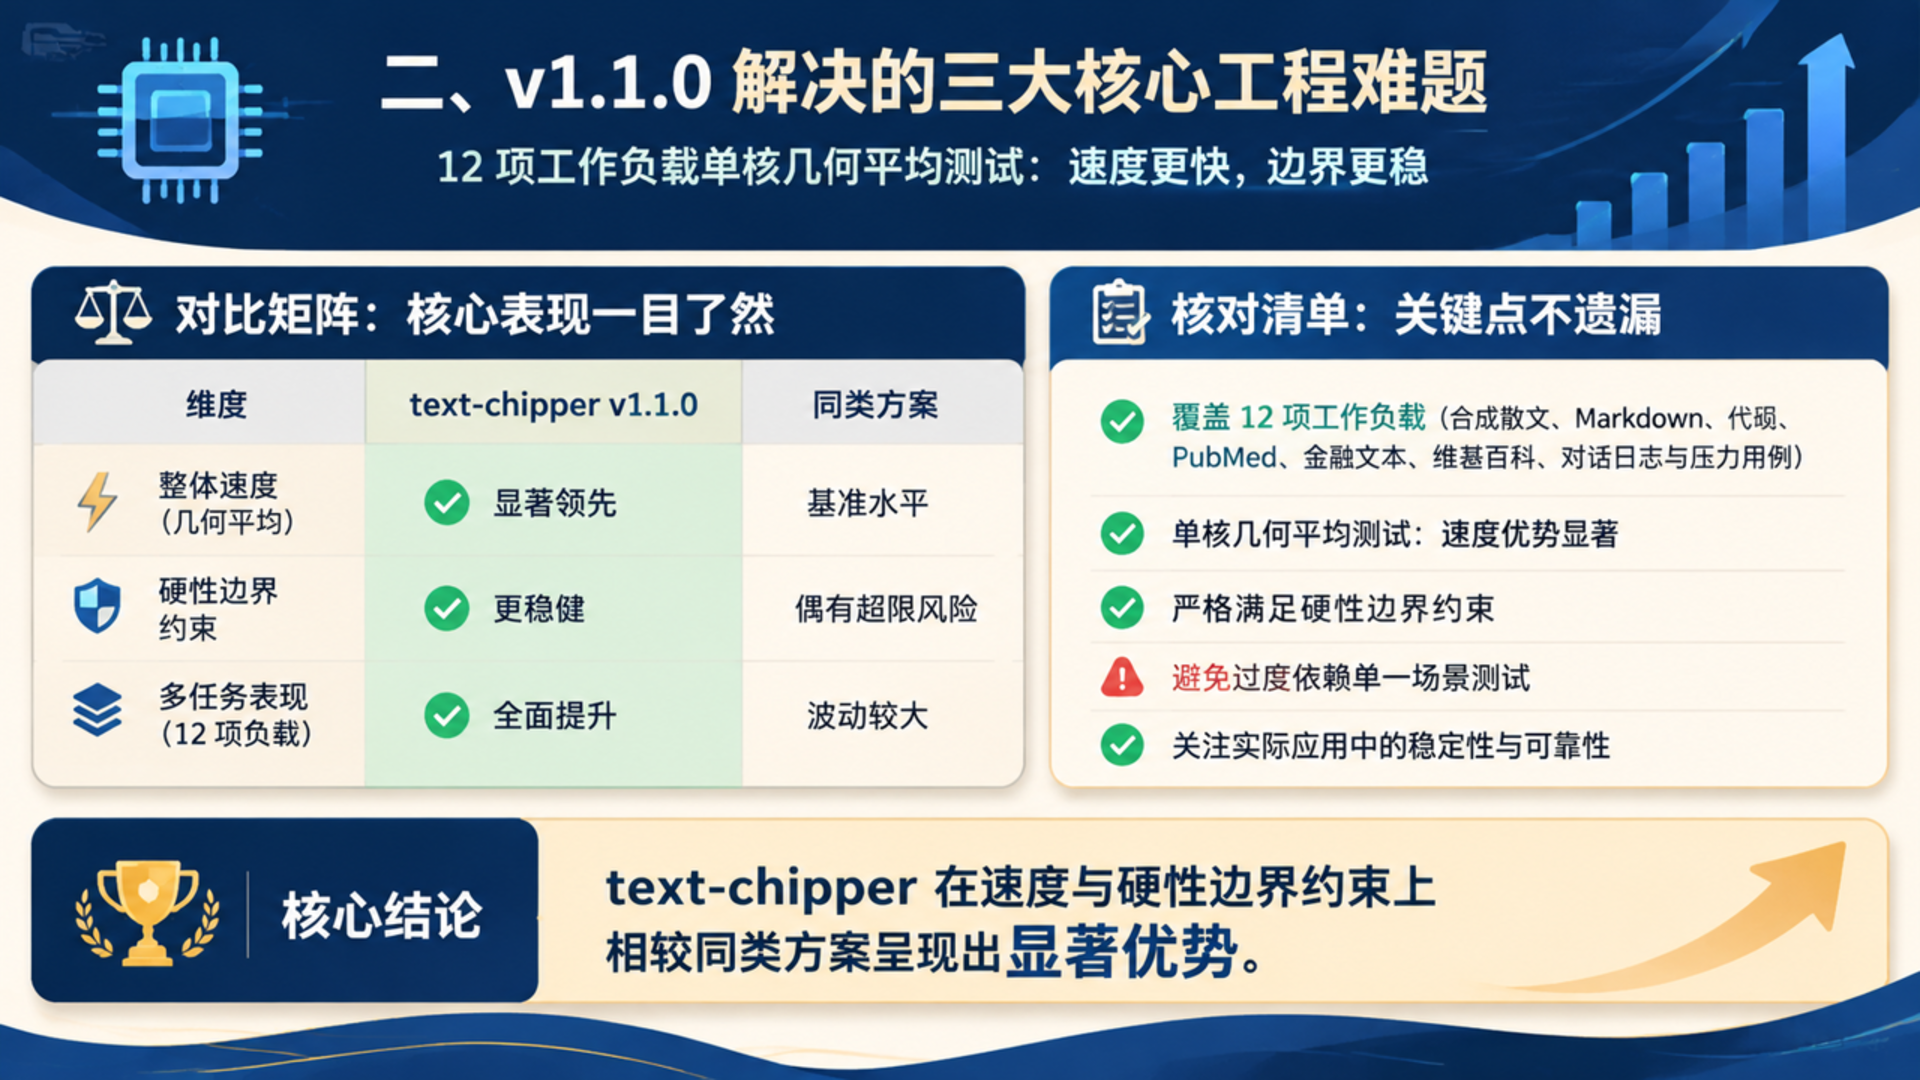
| 分块方案(512 Token 上限) | 单核几何平均吞吐 | 超过 512 Token 块数 | 结构与依赖特征 |
| :— | :— | :— | :— |
| text-chipper v1.1.0(严格模式) | 37.1 MiB/s | 0 块(全部 12 项负载) | 100% 保留小代码块(392 / 3,434 处),0 运行时依赖,wheel 约 4 MB |
| 朴素 tiktoken 滑动窗口 | 15.5 MiB/s | 18 块 | 无结构感知,易截断单词与代码块 |
| 其他主流分块库(LangChain 等) | 3.2 – 9.5 MiB/s | LangChain 15 块(最高 514 Token);Chonkie 18 块 | 速度慢 3.9–11.6 倍,引入较多运行时依赖 |
在安装与冷启动指标上,作者指出该库导入耗时约 2 ms,已发布轮子体积约 4 MB,适用于高并发索引任务与轻量容器部署。
二、v1.1.0 解决的三大核心工程难题
1. 保留精确源偏移的 Markdown 表格分块
面对 200 行的长表格,如果把第 0 行的表头强行注入第 2..N 块的正文字符串 chunk.text 中,会直接破坏 doc[chunk.start_index:chunk.end_index] == chunk.text 这一用于引用高亮和溯源的字节偏移不变量(作者在发布测试套件中对该不变量执行了 2690 万次校验)。text-chipper v1.1.0 的解法是:
- 整表若能装入
max_length则绝不拆分; - 超长表格按行边界(
R_ITEM)切分,第 1 块自带原始表头,第 2..N 块的chunk.text仅保存连续数据行切片,同时把表头与分隔符存入chunk.table_header,并在chunk.contextualized_text中自动前置拼接; - 在行打包前预先扣除重复表头的 Token 预算,并在终检门禁对
contextualized_text二次复算,杜绝溢出。
2. 零 GIL 加载 Hugging Face 分词器与双分词器守卫
对于使用 BAAI/bge-large-en-v1.5、Qwen 或 Llama-3 的本地推理流水线,直接拿 OpenAI 的 cl100k_base 估算长度极易误判(500 个 cl100k_base Token 在目标模型下可能超过 610 个 Token)。但若在 Python 回调里反复探测 AutoTokenizer,每次探针都要抢占 Python GIL,导致多线程吞吐坍塌。text-chipper 在初始化阶段通过 .backend_tokenizer.to_str() 提取序列化 JSON,直接送入 Rust 原生 tokenizers crate(Backend::from_tokenizer_bytes),分块期间完全释放 GIL 且零 Python 回调。此外,新增的 guard_tokenizers 参数支持同时传入嵌入模型与重排模型(如 bge-reranker-v2-m3)分词器,确保单块同时满足多模型词表的长度上限。
3. 大文件流式分块的有界内存控制
针对 500 MiB 以上的日志或全量导出文件,传统整文件读入字符串的做法会导致示例中的 514.3 MiB 文件引发 4.6 GB 进程内存峰值。text-chipper 利用增量式行驱动状态机 from_file_stream(path),在单核上用 25 秒完成该 514.3 MiB 文件处理(约 20.5 MiB/s),整个过程内存增长仅为 56 MB,并在活动水位线之后即时修剪 Unicode 归一化偏移映射表。
三、对 OpenLX 检索基础设施与信源加工的启发
在构建文旅知识图谱与独立站长文档索引时,保留 Markdown 表格表头语境与精确字符偏移是保证 AI 搜索引用可溯源的关键基础。text-chipper 将“源切片不变”与“模型上下文补全”拆分为 chunk.text 与 chunk.contextualized_text 两个正交字段的做法,非常值得在第一方知识库切分与向量入库工程中直接借鉴。
参考来源
- 技术博文原件:Omer Cihangiroglu,《37.1 MiB/s with Zero Token Overflows: Guaranteed Token Budgets and Table-Aware Chunking in text-chipper》(DEV Community,发布于 2026-11-21,采集核验时间:2026-11-22):https://dev.to/kameh0use/371-mibs-with-zero-token-overflows-guaranteed-token-budgets-and-table-aware-chunking-in-34bl
本文首发于 OpenLX文旅GEO·文旅AI信源基础设施(https://openlx.cn/),转载请注明出处与完整链接。