核心摘要:GitHub公开仓库
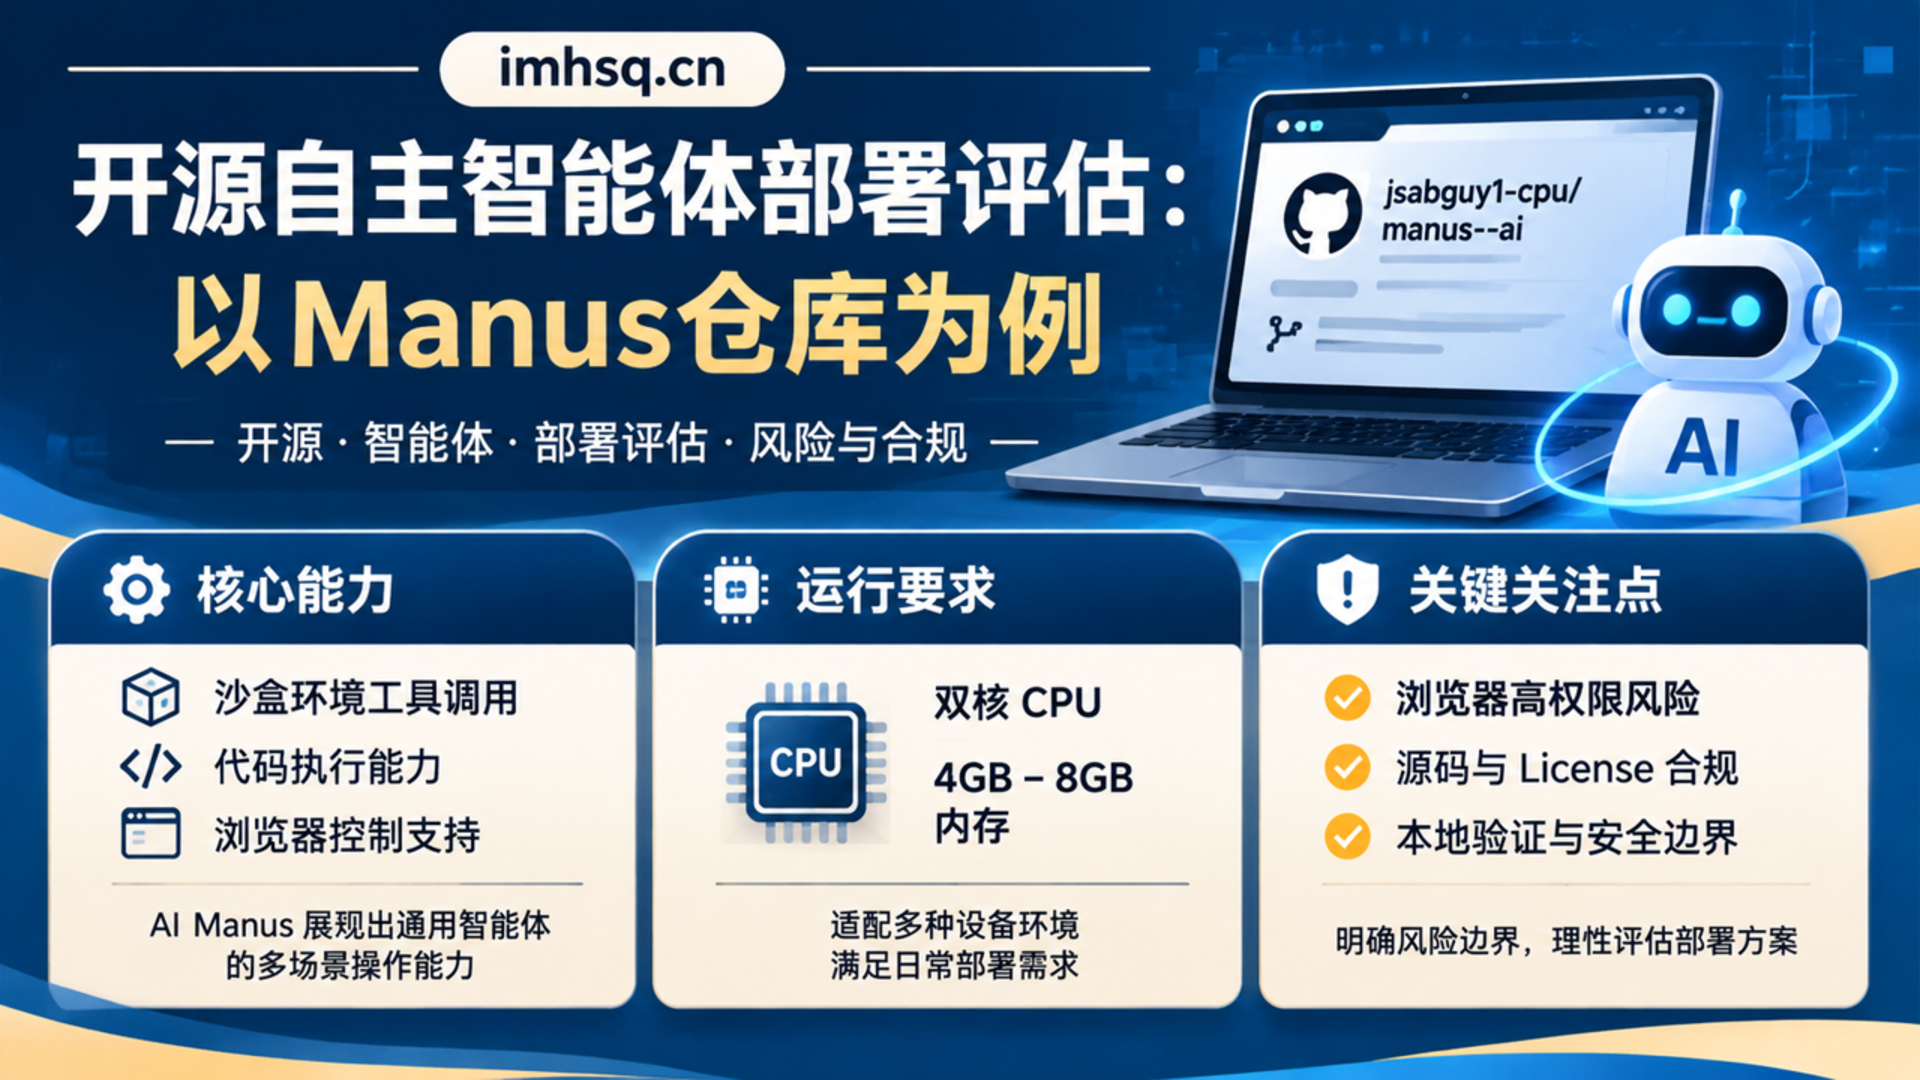
jsabguy1-cpu/manus--ai将AI Manus定义为可在沙盒环境中运行工具、执行代码并控制浏览器的通用智能体。本文基于该仓库公开README与元数据做技术线索拆解,梳理企业与个人在引入此类代码与浏览器双驱动Agent前必须核验的沙盒隔离、权限边界与本地验证清单。
在研究开源AI Agent工作流时,我们经常会遇到一个常见困惑:GitHub上标榜“自主执行代码与控制浏览器”的项目层出不穷,但真正要把它接入企业内部流程或内容运维管线时,只看项目简介里的亮点清单往往远远不够。最近在跟踪GitHub开源生态的Agent技术线索时,我注意到了jsabguy1-cpu/manus--ai这个公开仓库,今天就以它已公开的仓库信息为样本,拆解一次克制的部署前技术评估。
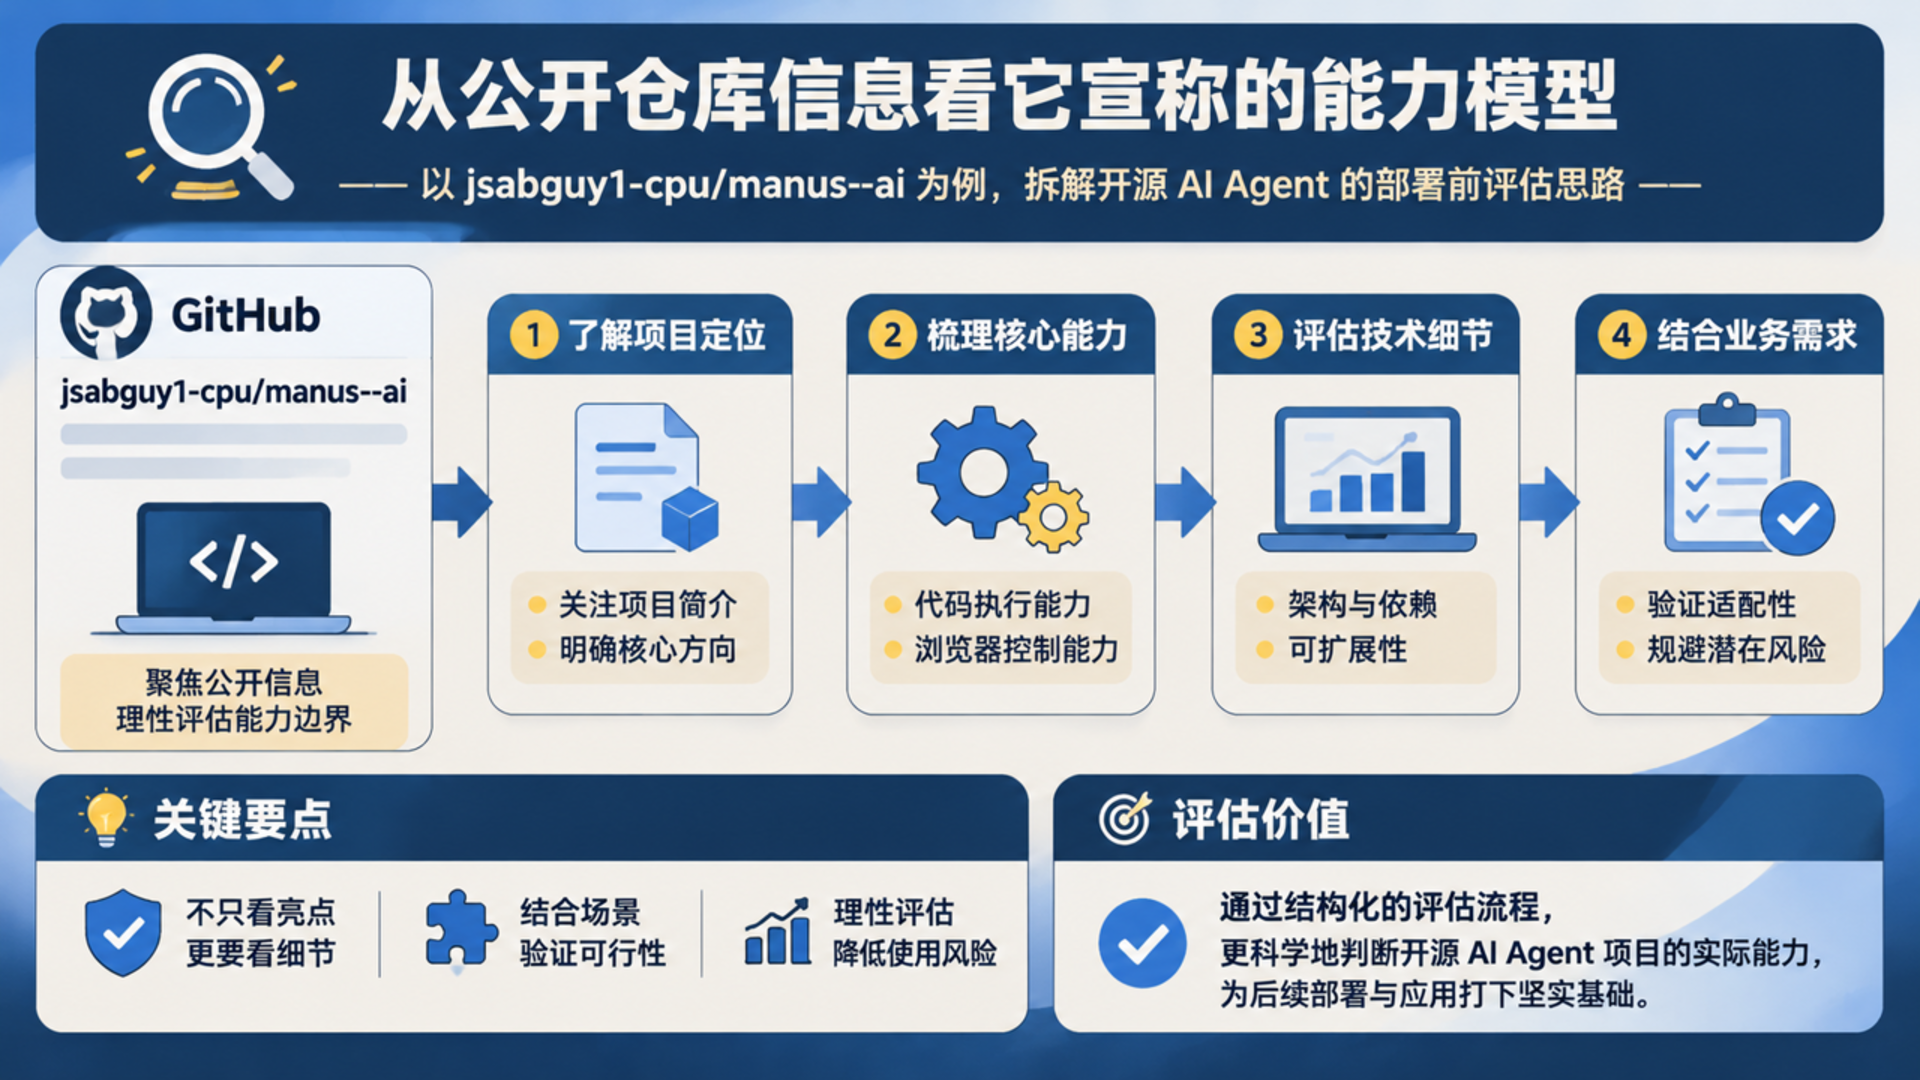
需要首先明确证据边界:本文对jsabguy1-cpu/manus--ai的分析仅基于截至2026年11月19日该仓库GitHub主页与README公开披露的文档线索,尚未完成本机沙盒环境下的克隆编译与端到端验证。公开文档中的功能描述属于项目作者声明,不代表在生产环境中的实际稳定性或安全表现。
从公开仓库信息看它宣称的能力模型
根据jsabguy1-cpu/manus--ai仓库主页及README公开内容,该项目定位为“在沙盒环境中运行各类工具和操作的通用AI Agent系统(AI Manus)”。从仓库标签与公开信息来看,其技术栈与特性分布如下:
| 评估维度 | 仓库公开披露信息 | 部署评估关注点 |
| — | — | — |
| 项目体量与活跃度 | 197 Stars、3 Watchers、411 Commits(公开页显示Apache-2.0、MIT许可标识) | 需进一步核查Commits实际代码构成、依赖树及核心源码目录结构 |
| 核心执行能力 | 宣称支持自主代码执行(Code Execution)与浏览器控制(Browser Control) | 重点验证脚本生成与浏览器动作之间的上下文传递与异常回滚机制 |
| 适用硬件基准 | 文档列明最低双核CPU、4 GB内存,推荐多核CPU、8 GB及以上内存与64位系统 | 本地并发运行无头浏览器与沙盒容器时,实际内存峰值往往高于静态建议 |
| 权限前提描述 | 明确指出完整浏览器控制可能需要提升权限(Elevated rights) | 这是企业私有化或FDE前置部署中最需要收紧的安全红线 |
在README的描述中,这类Agent试图解决的痛点非常明确:把“查网页、填表单、写脚本、跑计算”串联进同一套工作流,避免用户在命令行与浏览器窗口之间反复切换,并通过跨会话记忆复用同一套操作模式。这种思路与当前多模态、多工具协同的Agent工程方向是一致的。
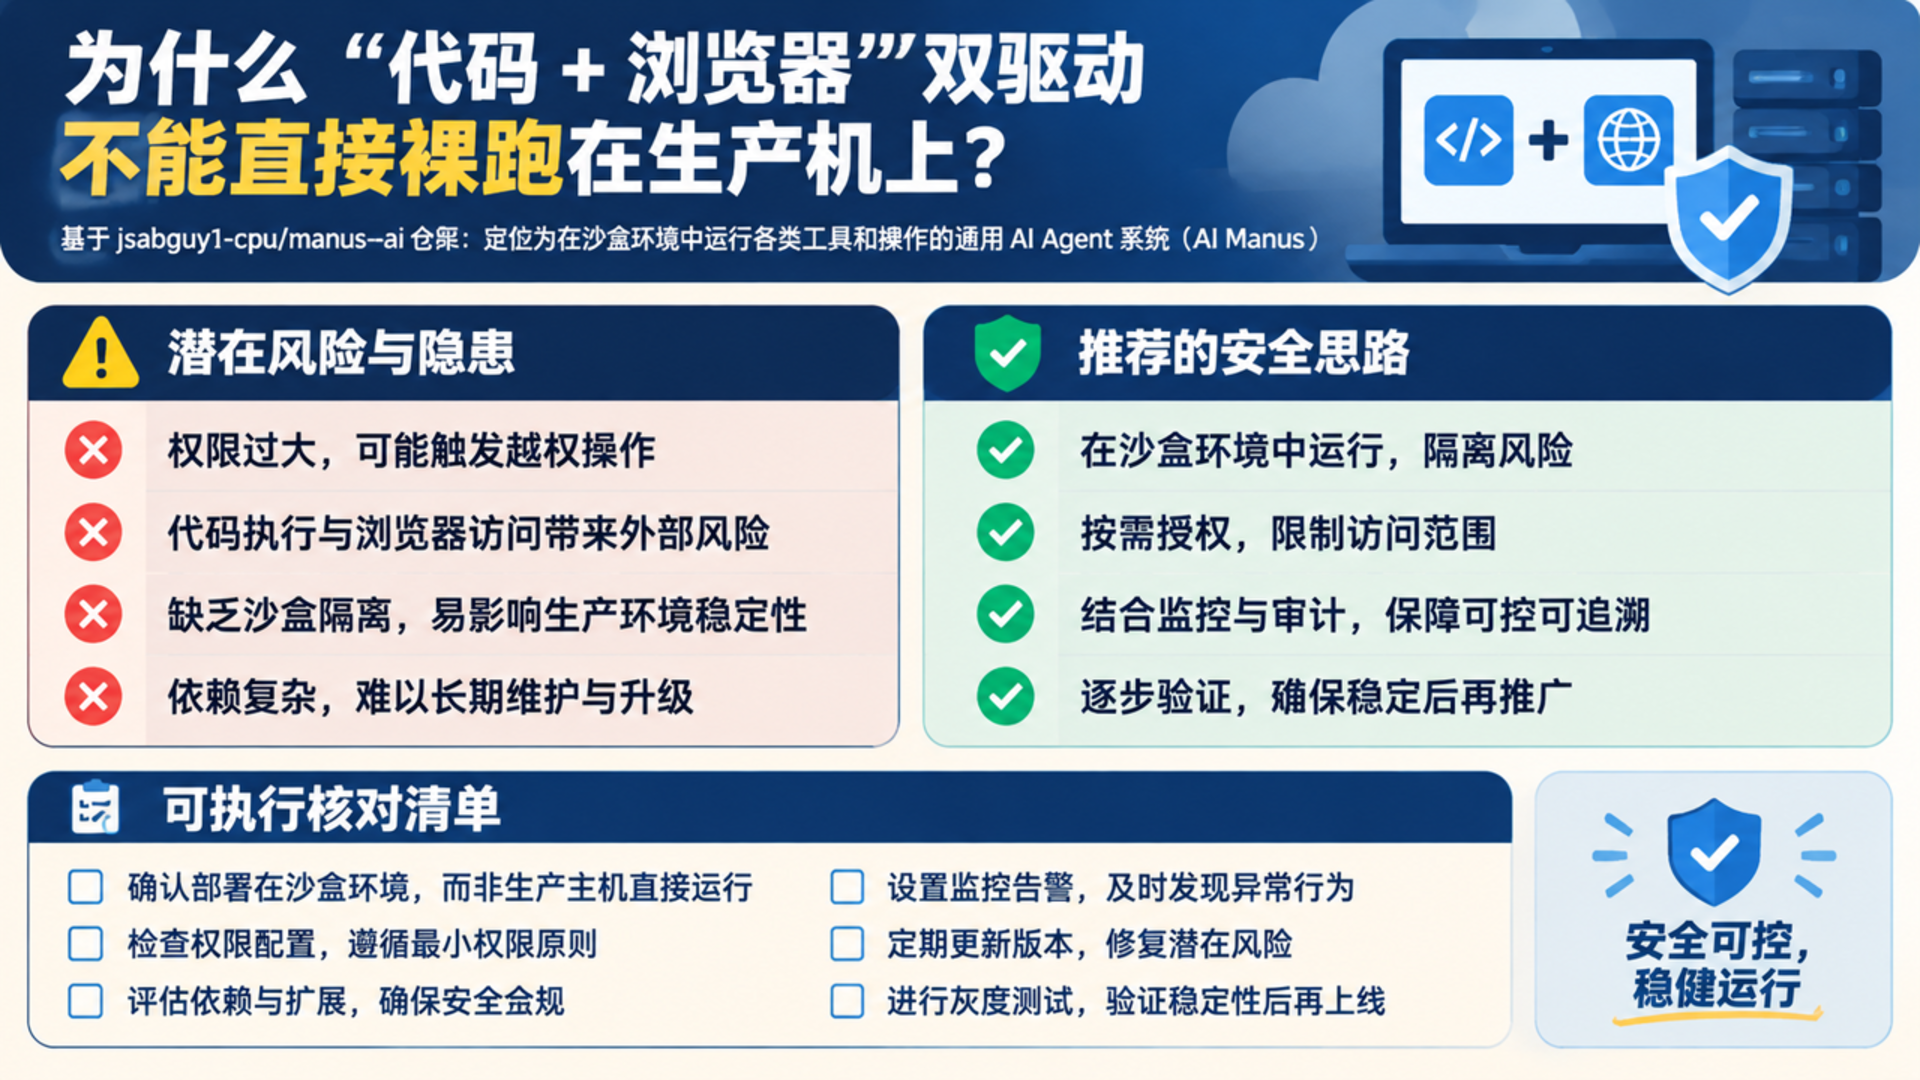
为什么“代码+浏览器”双驱动不能直接裸跑在生产机上
从OpenLX长期在企业AI部署与自动化管线中积累的工程经验来看,凡是同时拥有“代码执行权”和“浏览器操作权”的Agent系统,在未经沙盒隔离和充分验证前,都不能直接赋予真实工作电脑或生产服务器的高权限。原因主要集中在三个层面:
第一,权限声明中的隐性风险。该仓库在Compatibility一栏中提示,完整的浏览器控制可能需要较高系统权限。一旦Agent在执行多步骤网页任务时遇到页面异常、注入文本或脚本误判,高权限进程就可能对宿主机文件、浏览器已登录Cookie或本地密钥造成越权影响。生产落地时,必须通过独立容器、受限账户和只读挂载把沙盒边界锁死。
第二,文档完备度与源码可审计性的核对缺口。当前采集到的公开主页目录列表仅能看到LICENSE、README.md与license.md的顶层展示,仓库同时列出了Apache-2.0与MIT两种许可标记,且README文本带有明显的营销介绍风格(包含PROMO2026等字样)。在真正投入工程试用前,技术人员必须拉取完整Commit历史与具体实现文件,核对是否存在空壳包装、硬编码接口或未声明的远程调用。
第三,跨步工作流的确定性与可观测性。自主Agent在演示场景下“自动规划步骤”很吸引人,但企业级AI部署更看重确定性:当网页DOM结构微调或某一步脚本超时时,系统是默默重试、胡乱点击,还是能立即暂停并留存可追溯的日志快照?这直接决定了它能否从“个人桌面小助手”变成可靠的团队生产力工具。
引入开源Agent前的四步本地验证清单
针对这类尚处于“公开线索已读取、尚待交叉验证”状态的开源Agent项目,无论是个人技术实践者还是负责企业AI落地的工程师,都可以按以下四步走完验证闭环再做选型结论:
- 源码与依赖安全初筛:先在隔离目录拉取完整仓库,检查核心执行引擎的代码量、真实依赖库与网络外联行为,核对License条款是否一致,排除纯模板仓库或异常脚本风险。
- 最小权限沙盒运行:使用独立虚拟机或无特权Docker容器启动,禁止挂载宿主机敏感目录,先用无登录态的公开静态测试页验证其基础命令与浏览器动作链路。
- 失败恢复与边界压测:刻意构造404页面、超时接口和格式错误的输入,观察Agent是否会陷入死循环、过度消耗Token或产生不可逆的副作用。
- 成本与人工接管点测算:记录完成单次典型任务(如多页信息汇总或结构化校验)所需的模型调用轮次与耗时,评估其相较于传统确定性脚本的真实性价比,再决定是纳入工具箱还是仅作思路参考。
对于开源AI Agent生态而言,保持好奇心与保持工程克制同样重要。把仓库公开宣称的能力、文档中的条件限制与自己动手验证后的真实表现分开记录,既是对技术事实的尊重,也是把AI安全、可靠地用进日常业务里的基本前提。
本文首发于 OpenLX文旅GEO·文旅AI信源基础设施(https://openlx.cn/),转载请注明出处与完整链接。