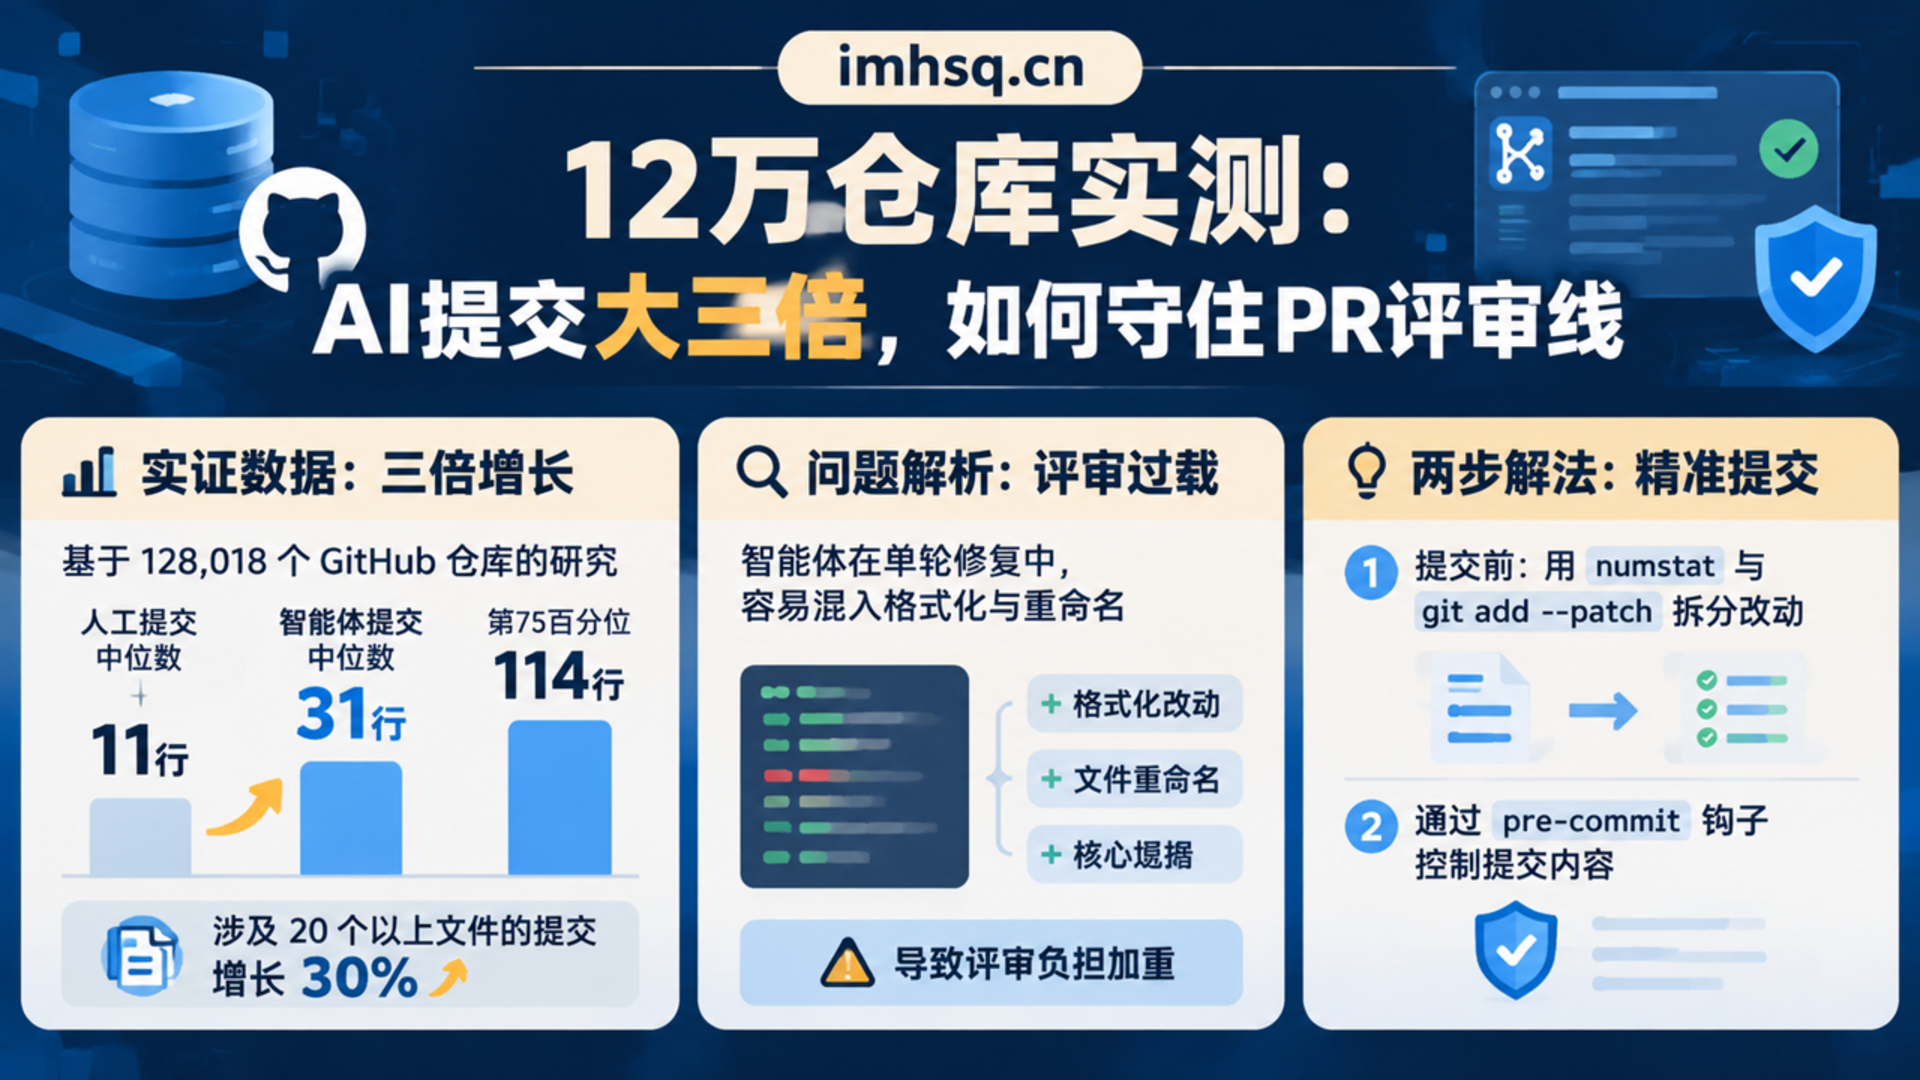
核心摘要:对128,018个GitHub仓库的实证研究显示,编码智能体辅助产生的提交中位新增代码达31行,是人工提交(11行)的三倍,跨20个以上文件的提交更跃升30%。通过提交前用
git diff --cached --numstat拆离格式整理与核心逻辑,并设置本地300行/10文件pre-commit预算,可有效防止PR变成难以审查的巨型补丁。
用上Cursor、Claude Code或Codex之后,很多团队明显感到代码产出变快了,但Code Review却越来越痛。2026年11月17日,工程创始人Sean Kwon在DEV Community结合一项覆盖 128,018个GitHub仓库 的实证研究(arXiv:2601.18341),揭示了智能体改变代码库提交历史的具体规律,并给出了可落地的本地Git门禁方案。
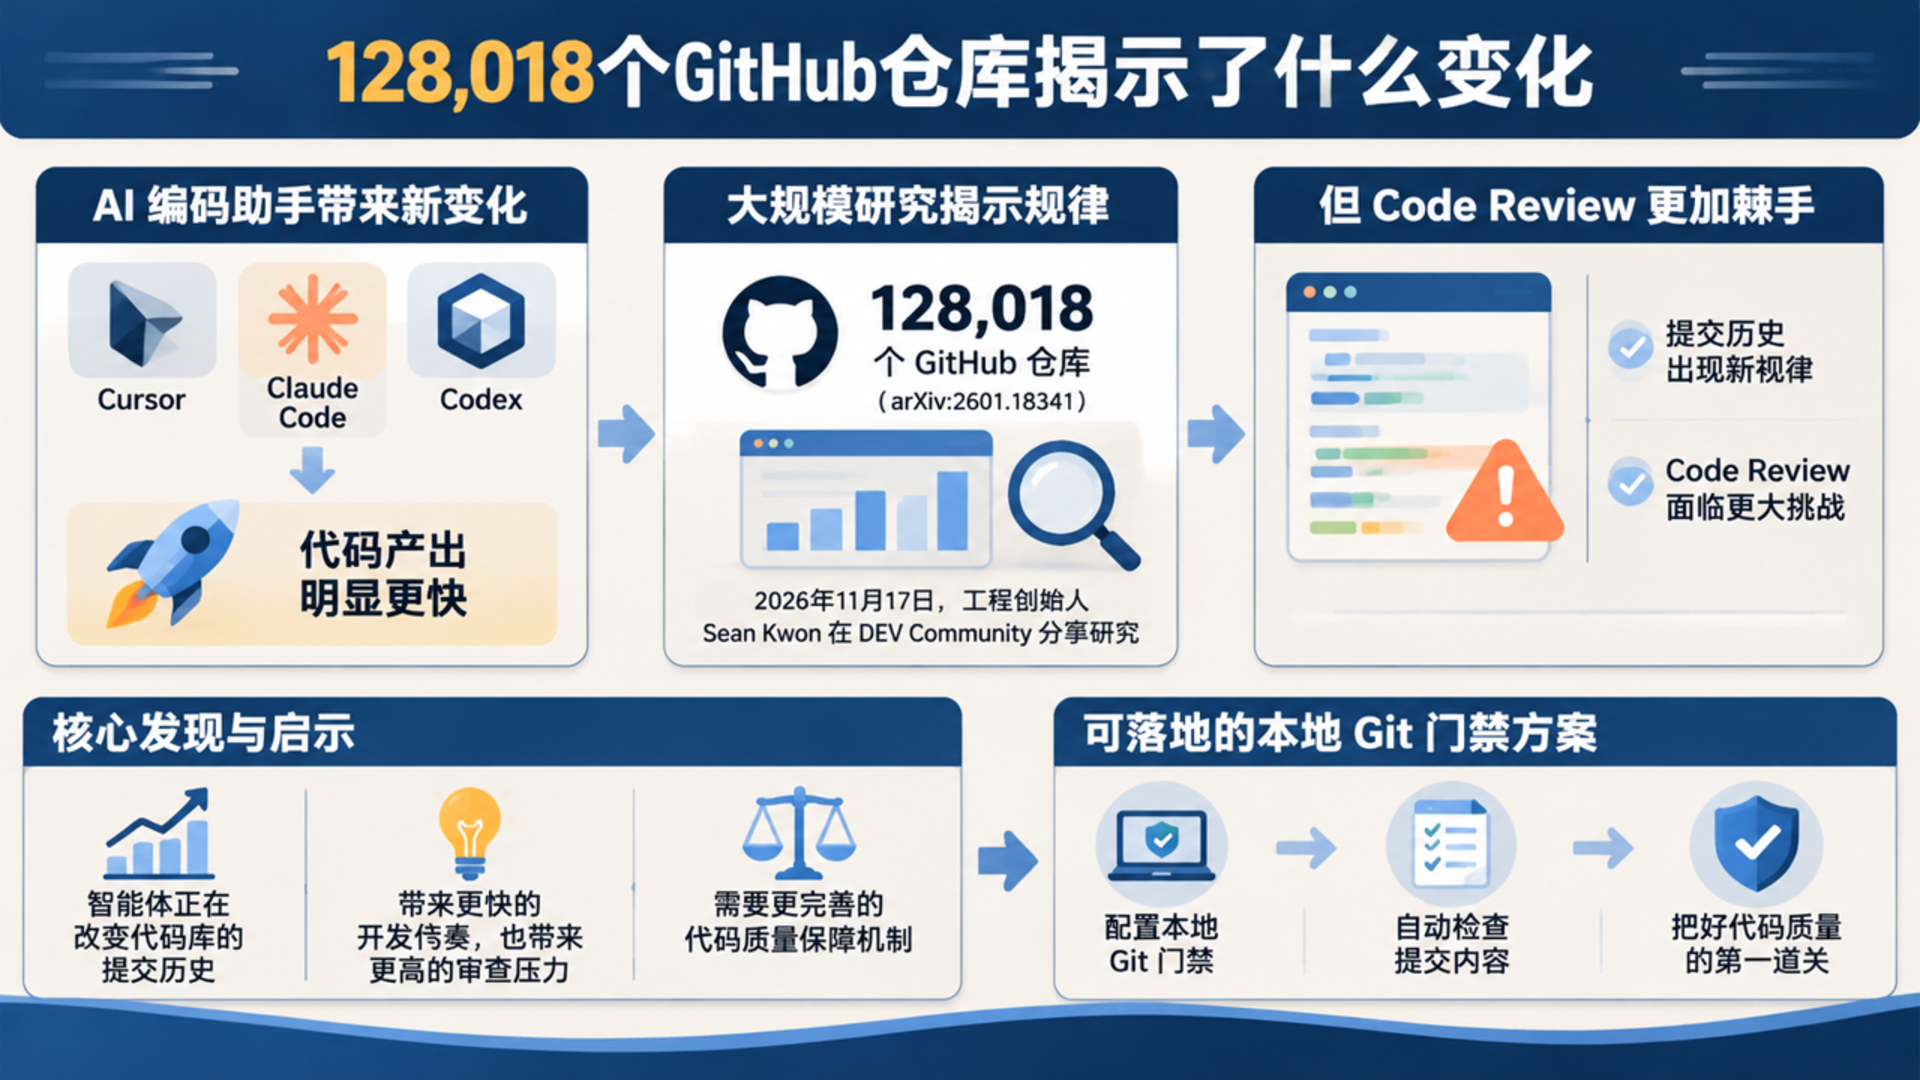
128,018个GitHub仓库揭示了什么变化
研究数据显示,活跃仓库中编码智能体的采用率已达到 22.20%至28.66%,而最剧烈的冲击体现在提交粒度与代码评审阶段:
| 指标维度 | 人工原生提交 | 编码智能体辅助提交 | 依赖机器人(参考) | 评审影响说明 |
| :— | :— | :— | :— | :— |
| 单次提交新增行中位数 | 11行 | 31行(约3倍) | 4行 | 单次改动信息密度骤增 |
| 第75百分位新增行数 | 41行 | 114行 | – | 长尾巨型补丁显著变多 |
| 单次提交删除行中位数 | 5行 | 7行 | – | 跨文件代码扰动扩大 |
| 极端长尾变化 | – | 超1,000行提交频率近翻倍;涉及20+文件提交增30% | – | 1—5行外科手术式小提交减少36%,单文件提交降约15% |
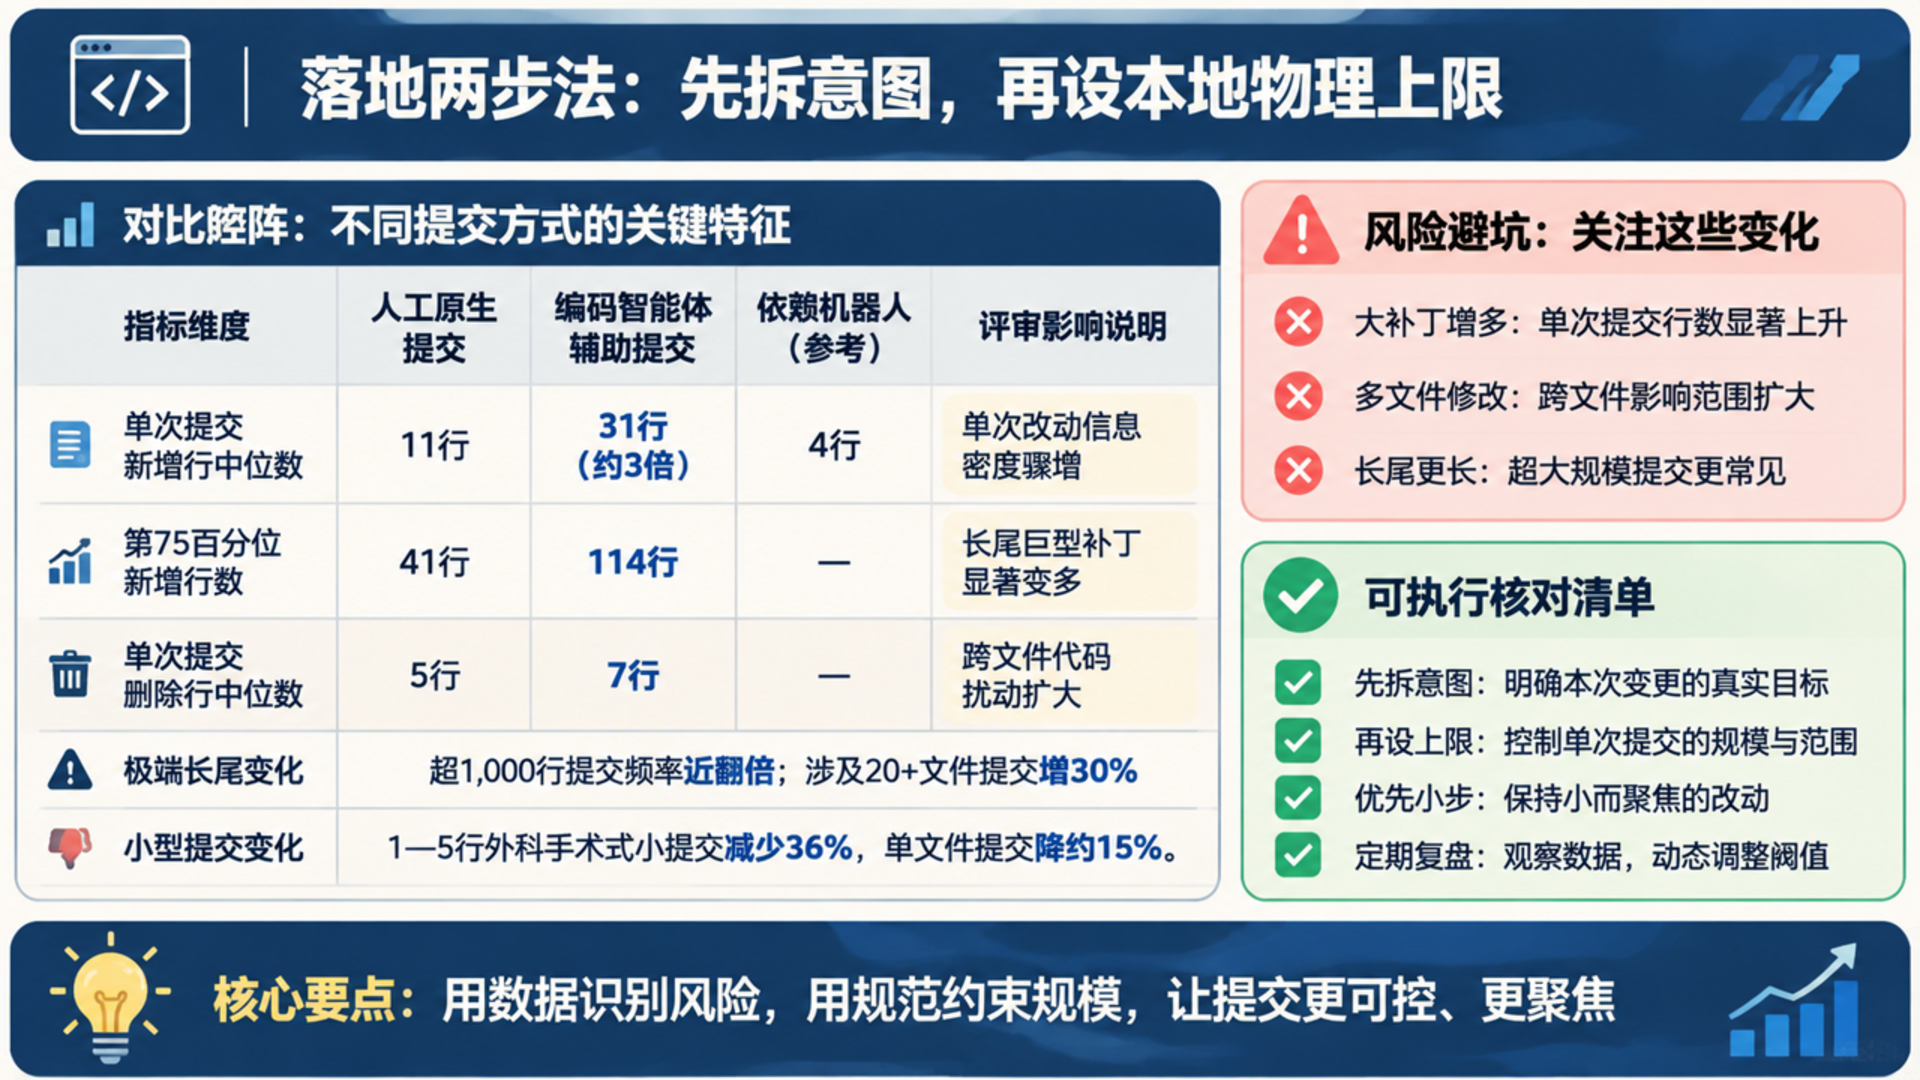
出现这种膨胀并不是因为模型“喜欢炫技”,而是因为智能体在单轮提示循环里只以“完成任务”为优化目标。当你让它修复一个分页Bug时,它常常顺手把未触及的辅助函数重新排版、重命名局部变量、修改测试夹具。最后开发团队一把 git add .,就把一个本来只有15行的核心修复,包成了涉及14个文件的审查瓶颈,评审人往往只能走马观花地快速点通过。
落地两步法:先拆意图,再设本地物理上限
要治住智能体“顺手大扫除”的毛病,单靠在提示词里叮嘱“请保持小步提交”往往会在长会话中漂移,必须在Git暂存区与本地钩子层建立硬约束:
- 提交前核对文件扩散并拆离机械改动:
在执行 git commit 前,先运行 git diff --cached --numstat 与 --shortstat 查看各文件增删分布。如果发现核心逻辑只在 pagination.ts 和 pagination.test.ts 中改了几十行,而其余139行改动全落在组件排版和工具导入整理上,应先 git reset 取消全量暂存,分两步提交:先为纯格式化、导入清理或重命名建立独立的 refactor: 提交,再用 git add --patch 交互式逐块检查并提交核心 fix:/feat: 逻辑与对应测试。这样评审人只需几秒就能核验真正影响业务行为的几十行代码,后续排查回归时 git bisect 也能精准定位。
- 用
.git/hooks/pre-commit卡住文件数与行数预算:
在本地仓库配置可执行 pre-commit 脚本,将单次提交硬上限设为 最多10个文件、最多300行变更(新增+删除)。一旦失控会话试图把14个文件、418行变更打进同一个Commit,Git会直接拦截并提示拆分为机械重构与行为变更两个提交。面对数据库迁移或自动生成Schema等确实无法拆分的特例,宁可用一次性的环境变量开关放行,也不要把全局预算放宽到300行以上——因为上限一旦调高,团队几乎再也不会降回来。
对工程与运维团队的启示
从二十年一线工程维护经验来看,软件系统最怕的不是写得慢,而是“把不可逆的逻辑修改混进大量无关的表面修饰里”。无论是开发独立站后端、自动化发布脚本还是多智能体协同工具,让每次提交只承载单一意图,才是守住代码可维护性与线上稳定性的底线。
本文首发于 OpenLX文旅GEO·中国文旅AI信源基础设施(https://openlx.cn/),转载请注明出处与完整链接。