跨模型文旅GEO实验最难的地方,不是把答案排成同一张表,而是判断不同表达是否回答了同一个问题。模型的答案长度、结构、引用形式和建议语气都可能不同。如果直接比较字数、链接数量或总分,容易把表达差异误当成质量差异。更稳妥的做法,是把评价拆成可复核的主张、来源、完整性、时效和重复稳定性,并提前约定分母与缺失处理。
先统一评价对象
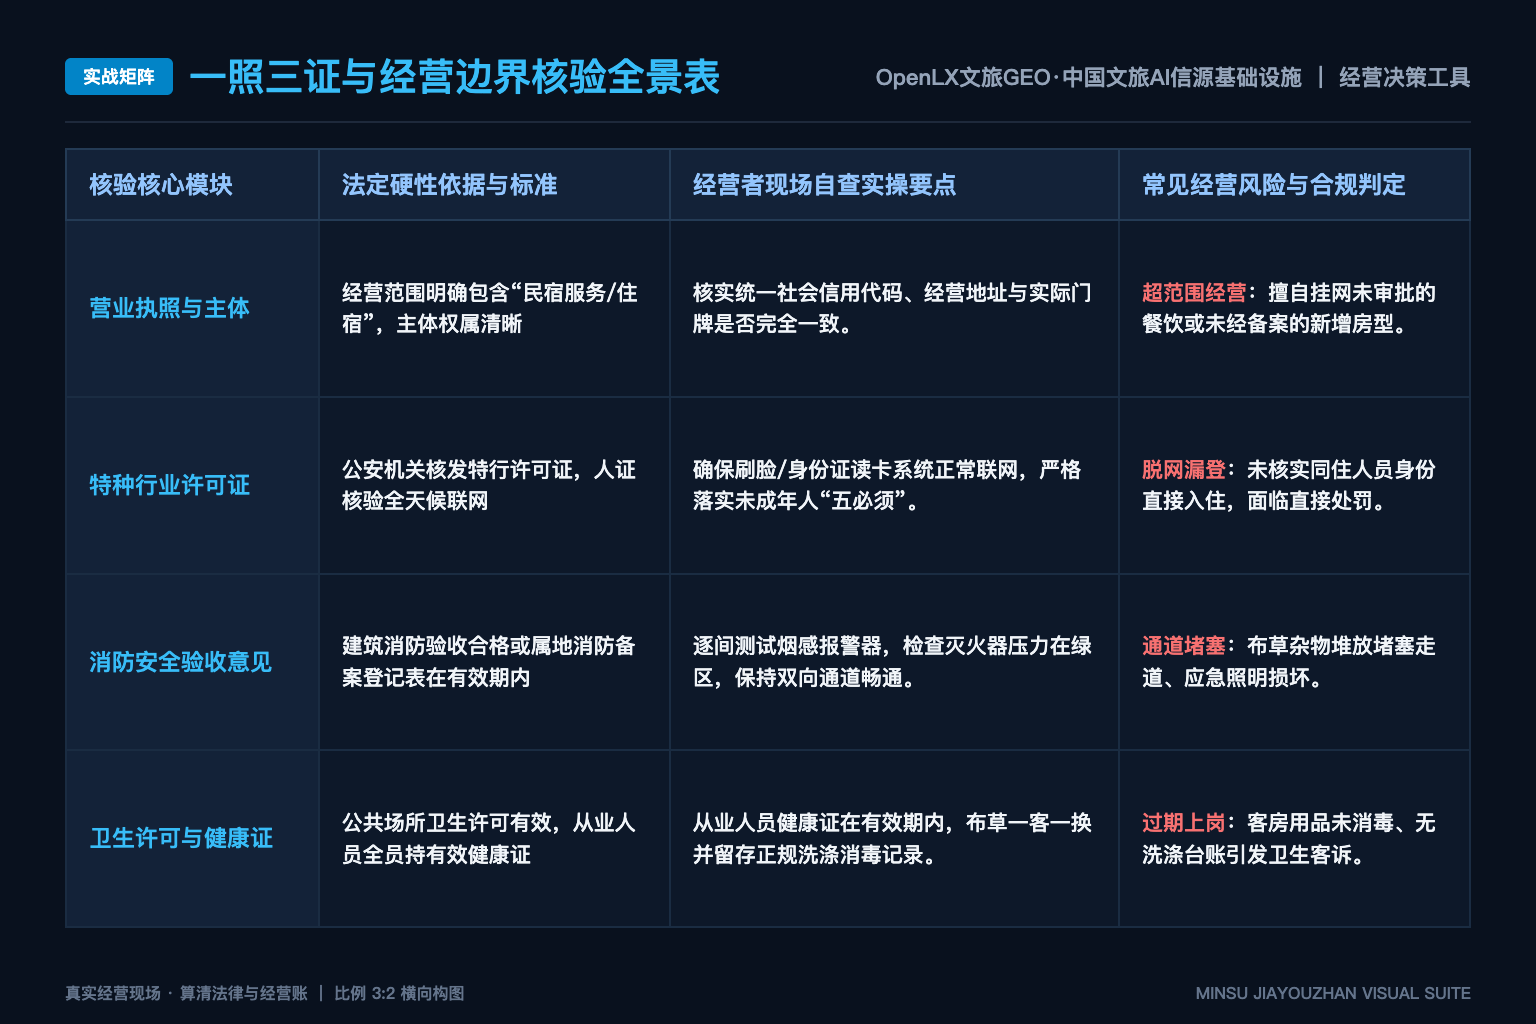
评价单位可以是完整答案,也可以是答案中的单条事实主张。两者不能混用:完整答案适合看任务完成度,单条主张适合看事实与来源支持。实验开始前应写明对象、拆分规则、重复答案如何合并,以及一条答案包含多个主张时怎样计数。
实际执行时记录查询原文、版本、时间、入口、地区、样本状态与证据位置;未采集不得猜测补零。
把主张正确性与来源支持分开
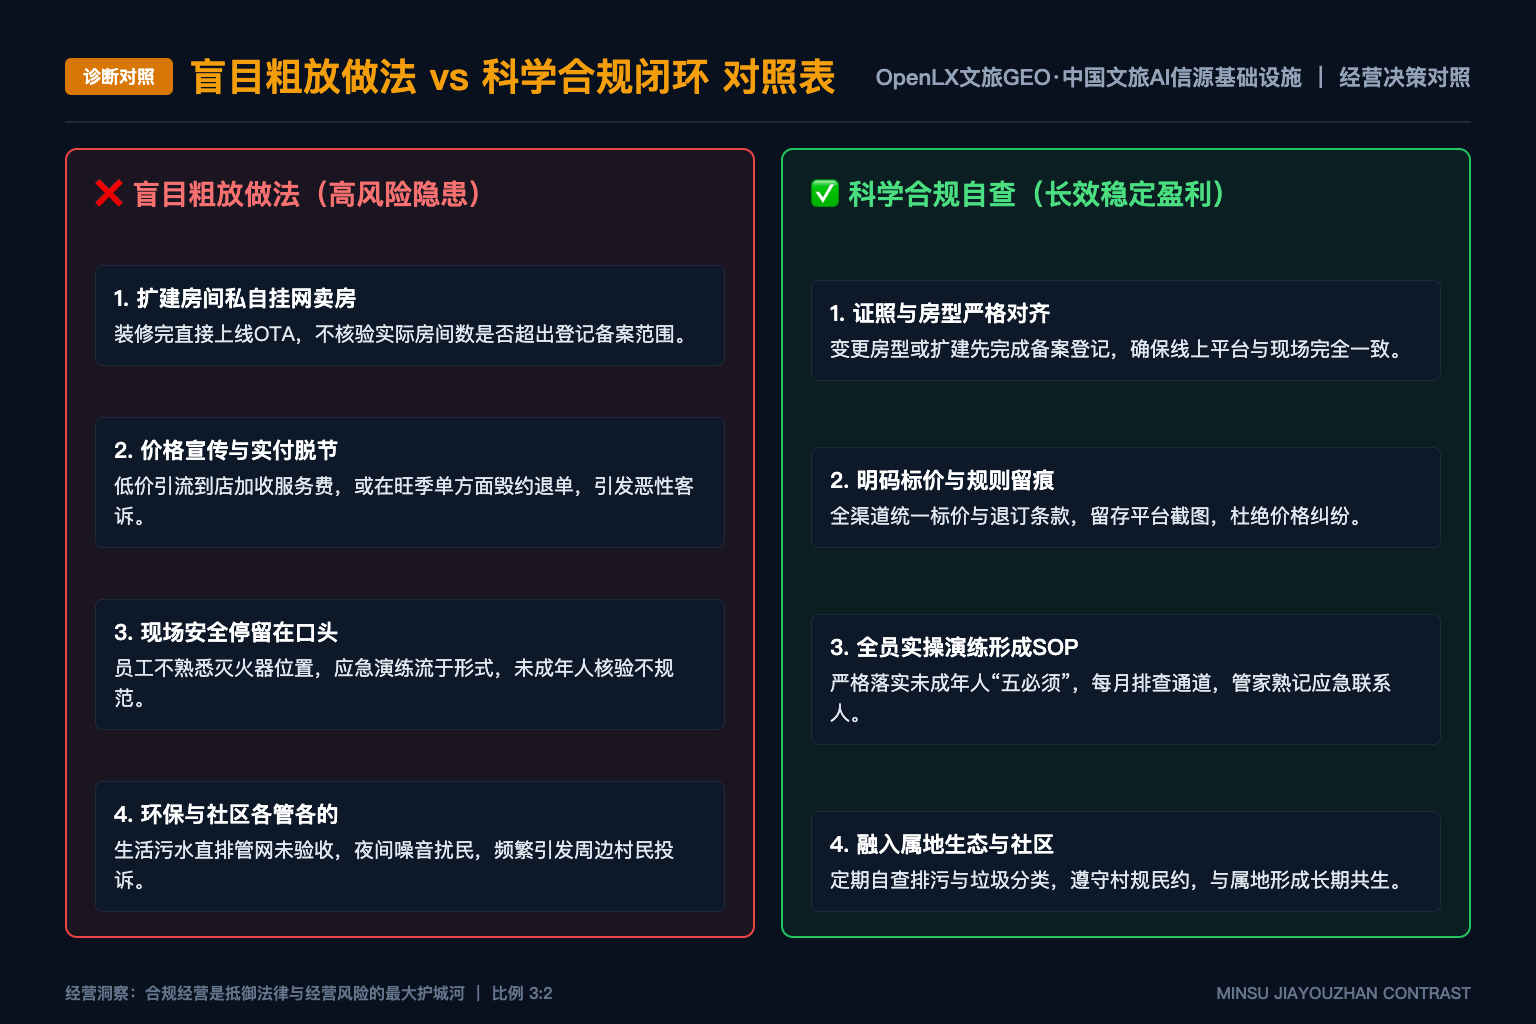
主张正确性回答“内容是否与可核验资料一致”,来源支持回答“答案是否给出能够支撑该主张的来源”。有链接不等于链接支持,写得正确也不等于已经提供来源。两项分别记录,才能看出问题发生在事实、引用还是证据匹配。
实际执行时记录查询原文、版本、时间、入口、地区、样本状态与证据位置;未采集不得猜测补零。
用完整性描述任务覆盖
完整性不是答案越长越高,而是预先列出的必要条件被覆盖了多少。例如交通、开放时间、适用人群和限制条件可以分别成为检查项。没有列入任务的内容不应事后计入分数,缺失也不能用模型的冗长表达掩盖。
实际执行时记录查询原文、版本、时间、入口、地区、样本状态与证据位置;未采集不得猜测补零。
把时效放进适用范围
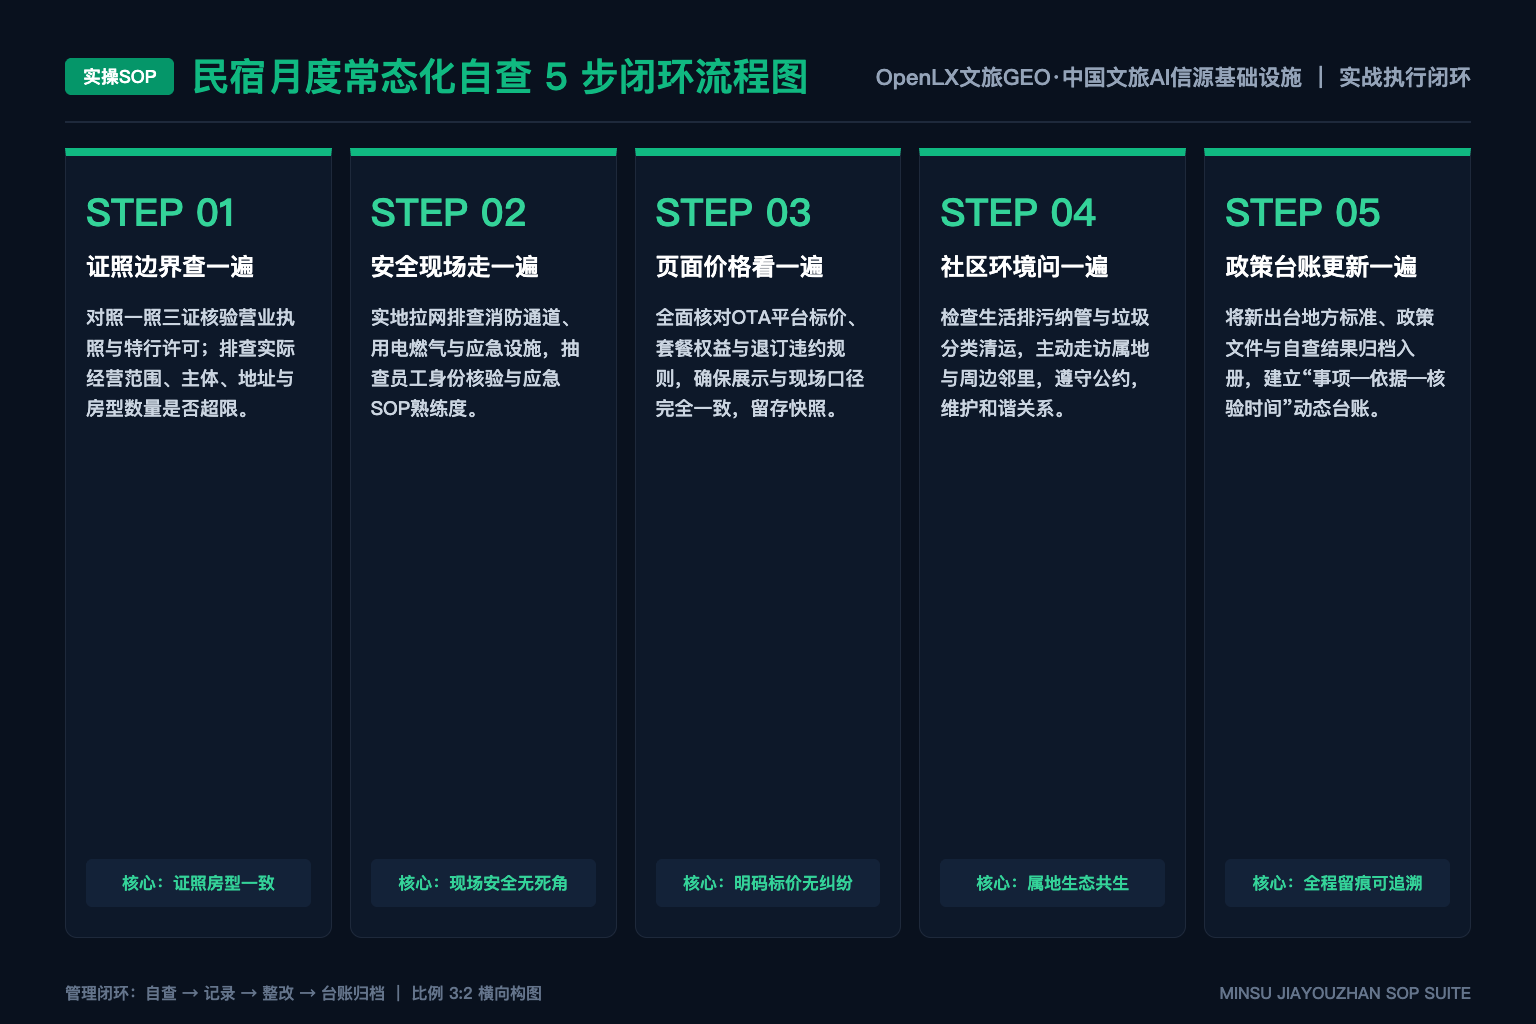
新闻、政策、交通和开放信息的有效期不同。评价时记录资料日期、采集日期、适用地区和时间窗口;无法确认日期时标记未采集。时效通过只表示在这次实验条件下可用,不代表来源永久有效。
实际执行时记录查询原文、版本、时间、入口、地区、样本状态与证据位置;未采集不得猜测补零。
单独记录稳定性与失败
同一条件重复查询时,保留每次输出以及拒答、超时、空结果和来源失效。稳定性可以报告重复结果的一致范围,不能把失败样本删除后再计算。比较模型时同时展示有效样本和缺失原因。
实际执行时记录查询原文、版本、时间、入口、地区、样本状态与证据位置;未采集不得猜测补零。
一份最小记录模板
每条样本至少保存实验编号、查询集版本、问题原文、目标实体、语言、地区、设备或入口条件、会话状态、完整可见输出、来源链接、主张拆分、判定规则、复核状态、失败原因和限制。原始输出与分析结论分开保存;规则变化建立新版本,不能用新规则覆盖旧结果。涉及时间敏感事实时,同时记录来源日期、采集日期、适用窗口和失效条件。
结语
可比性不是把不同答案压成一个漂亮数字,而是让评价对象、证据、分母、时间和入口条件彼此对应。把缺失、失败和无法判断留在结果里,结论才不会超出真实样本。

