核心摘要:Google近期发布的“系统1”决策模型Gemini Decision 1不逐字生成文本,而是单次前向输出布尔值、分数或分类,输入每百万Token仅$0.10且无输出计费。Patrick Kelly在2026年11月19日公布的800场景公开测试表明:把宽泛主观问题拆细为明确窄问题后,模型路由准确率可从0.72跃升至0.88,但预测用户纠偏仅46%,不适合替代主观判断与确定性代码。
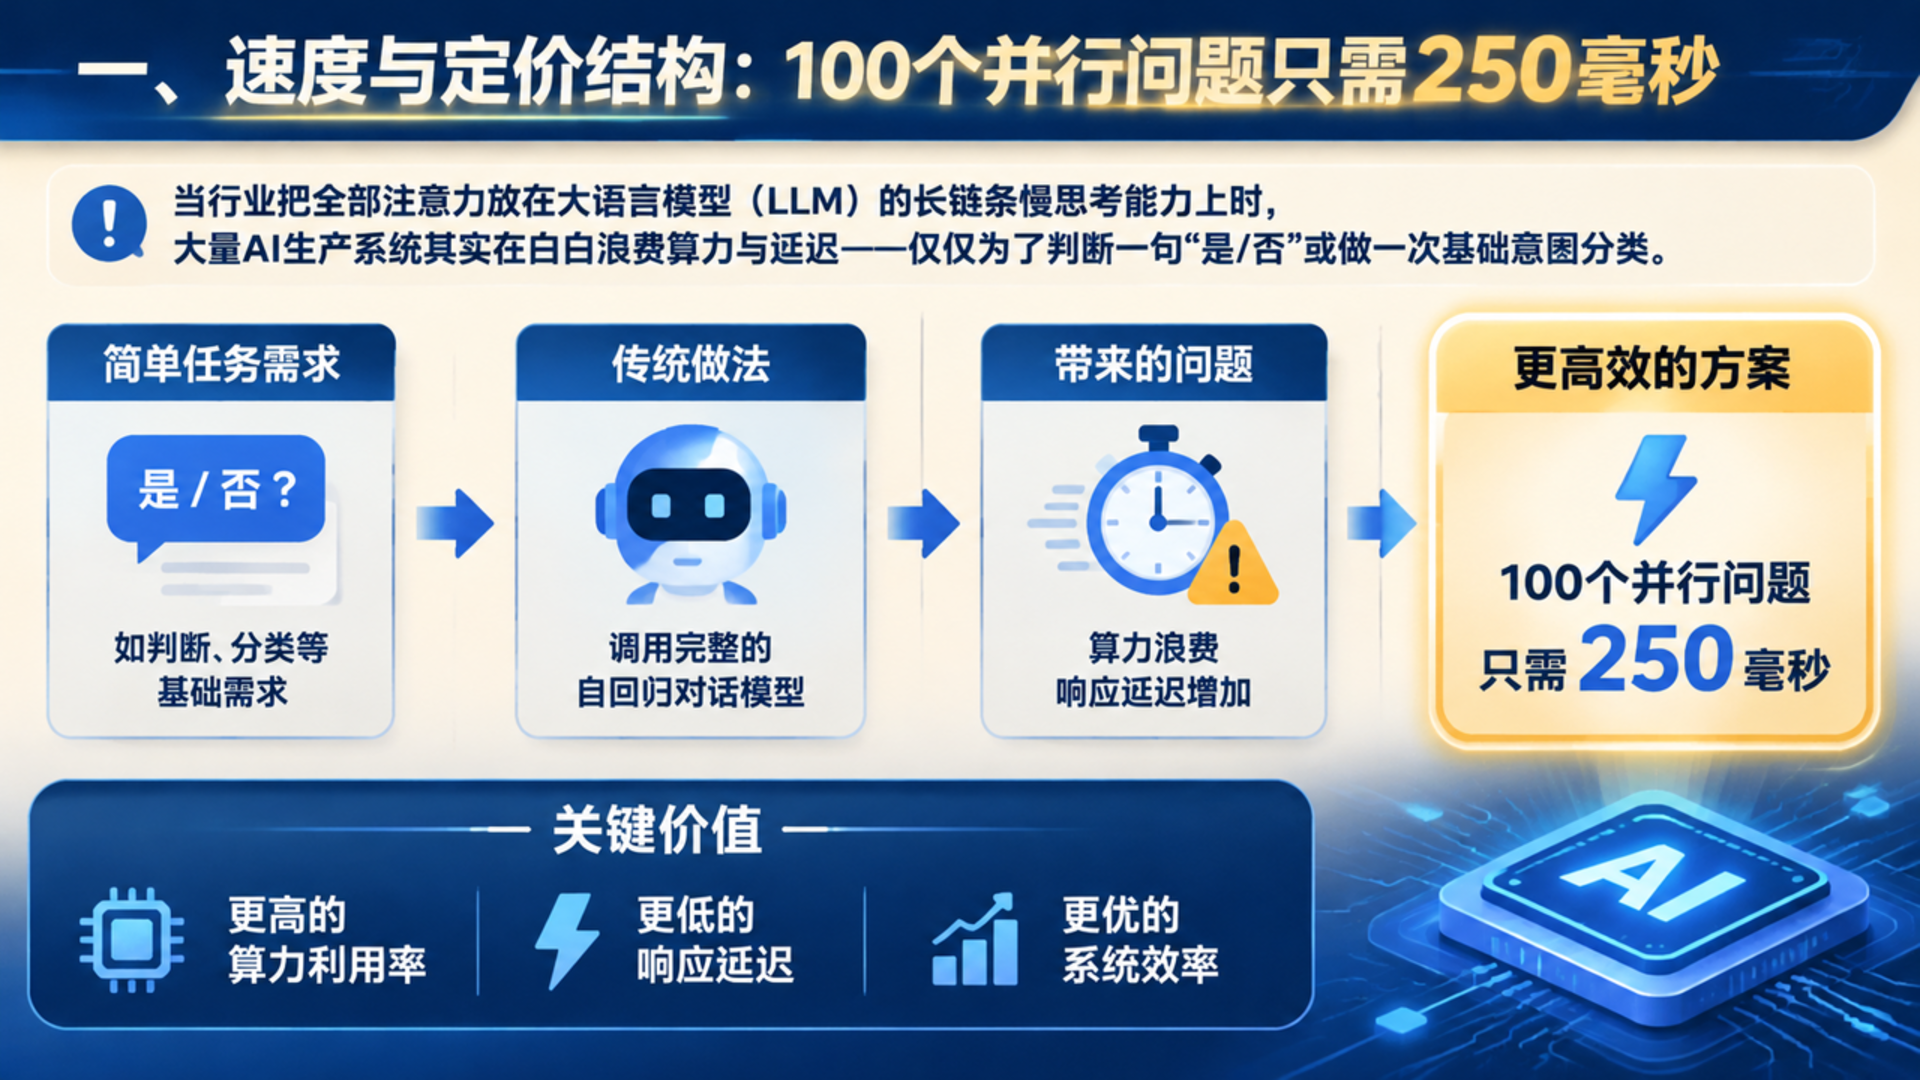
当行业把全部注意力放在大语言模型(LLM)的长链条慢思考能力上时,大量AI生产系统其实在白白浪费算力与延迟——仅仅为了判断一句“是/否”或做一次基础意图分类,就动辄拉起一次完整的自回归对话模型。
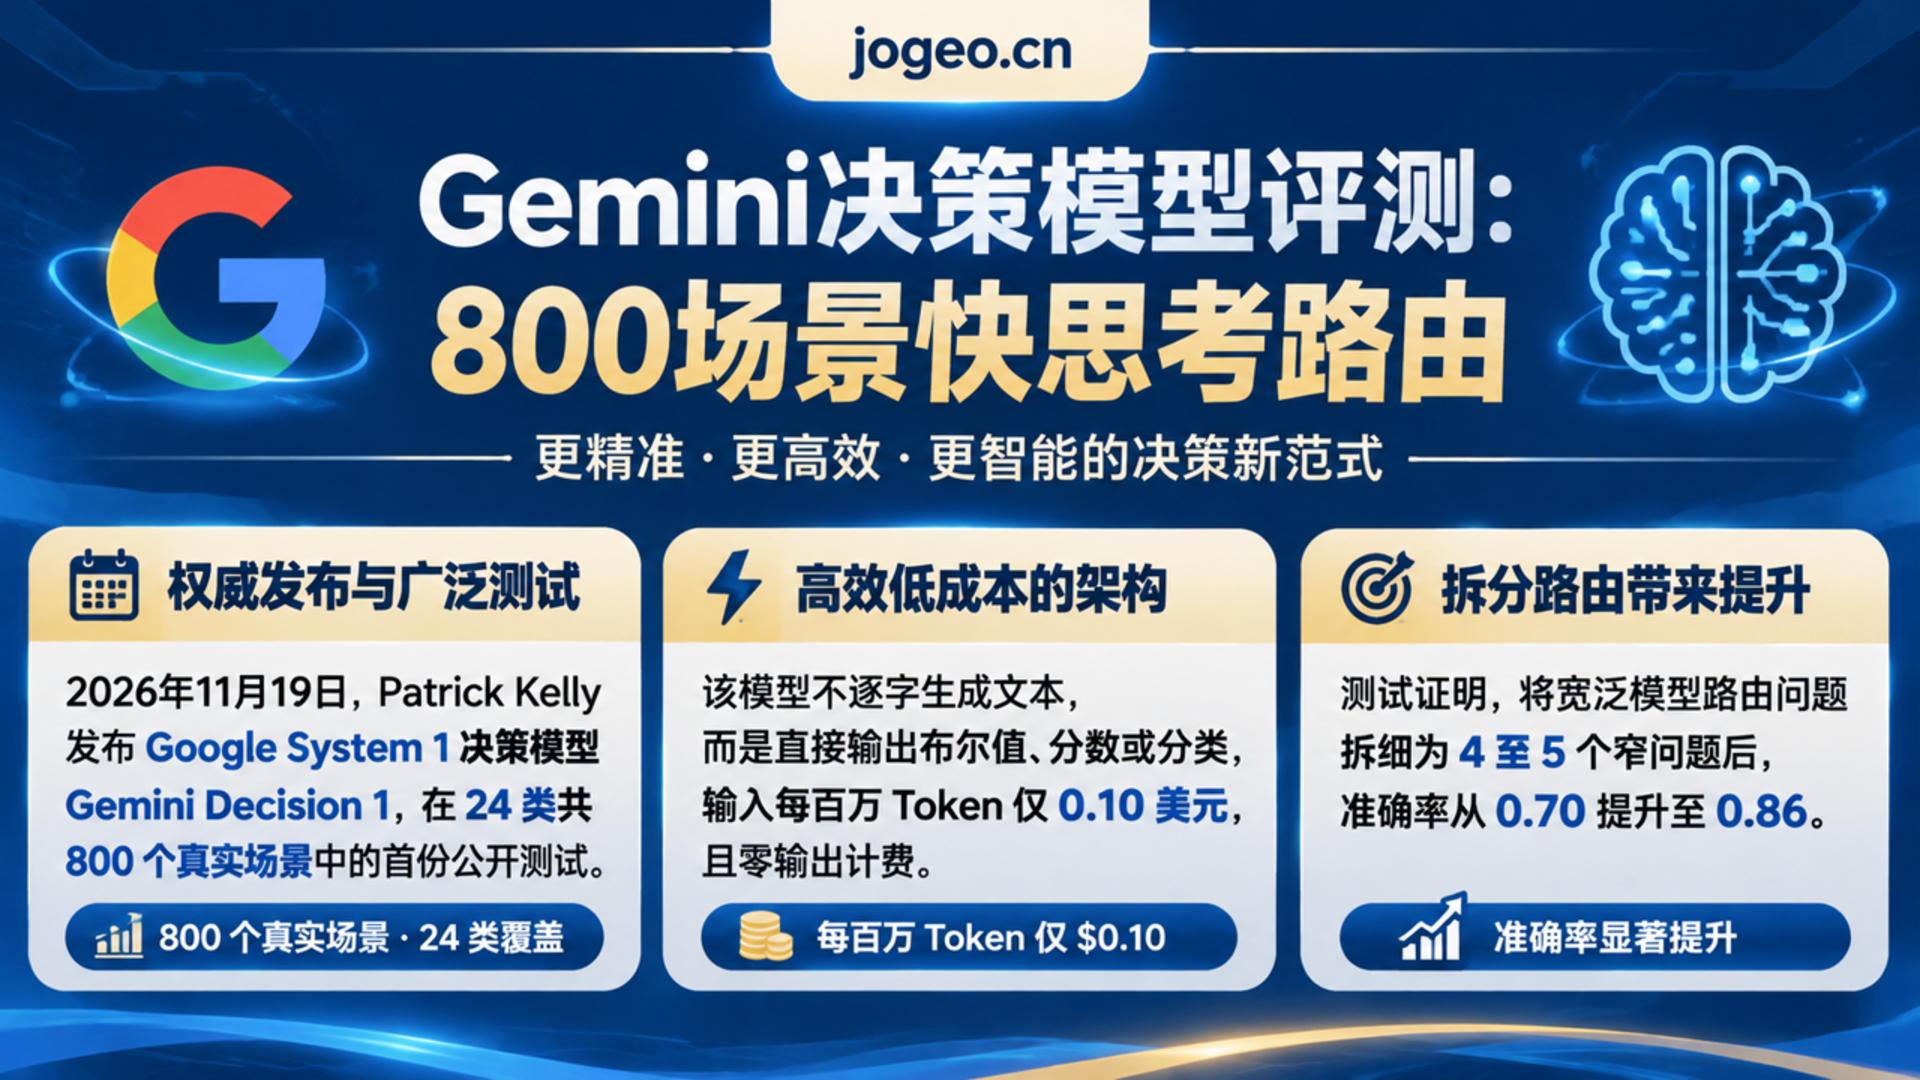
2026年11月19日,Google AI开发者Patrick Kelly发布了对Google近期推出的Gemini Decision 1(官方亦称之为“System 1”决策模型)的首篇深度公开测试。与逐Token吐出文本的对话模型不同,Decision 1单次读入输入后直接返回三类结构化统计输出之一:True/False布尔判定、数值评分(Score)或类别归属(Classification)。
一、速度与定价结构:100个并行问题只需250毫秒
因为没有自回归生成文本Token的过程,决策模型的延迟和计费曲线与普通LLM完全不在一个维度上:
- 批量并行几乎零边际延迟:单次请求最多可同时提交1,000个判断问题。作者公开测试,单次提问1个问题耗时约180ms,而同一请求内同时塞入100个检查问题也仅耗时约250ms。
- 零输出Token费用:Gemini Decision 1按每百万输入Token $0.10 计费,输出Token费用为 $0(Google免费层每日提供最高10000次免费请求)。
这意味着工程团队完全可以在一次前置请求里挂一整套核查清单,再用本地程序逻辑组合这些布尔信号来驱动路由与拦截。
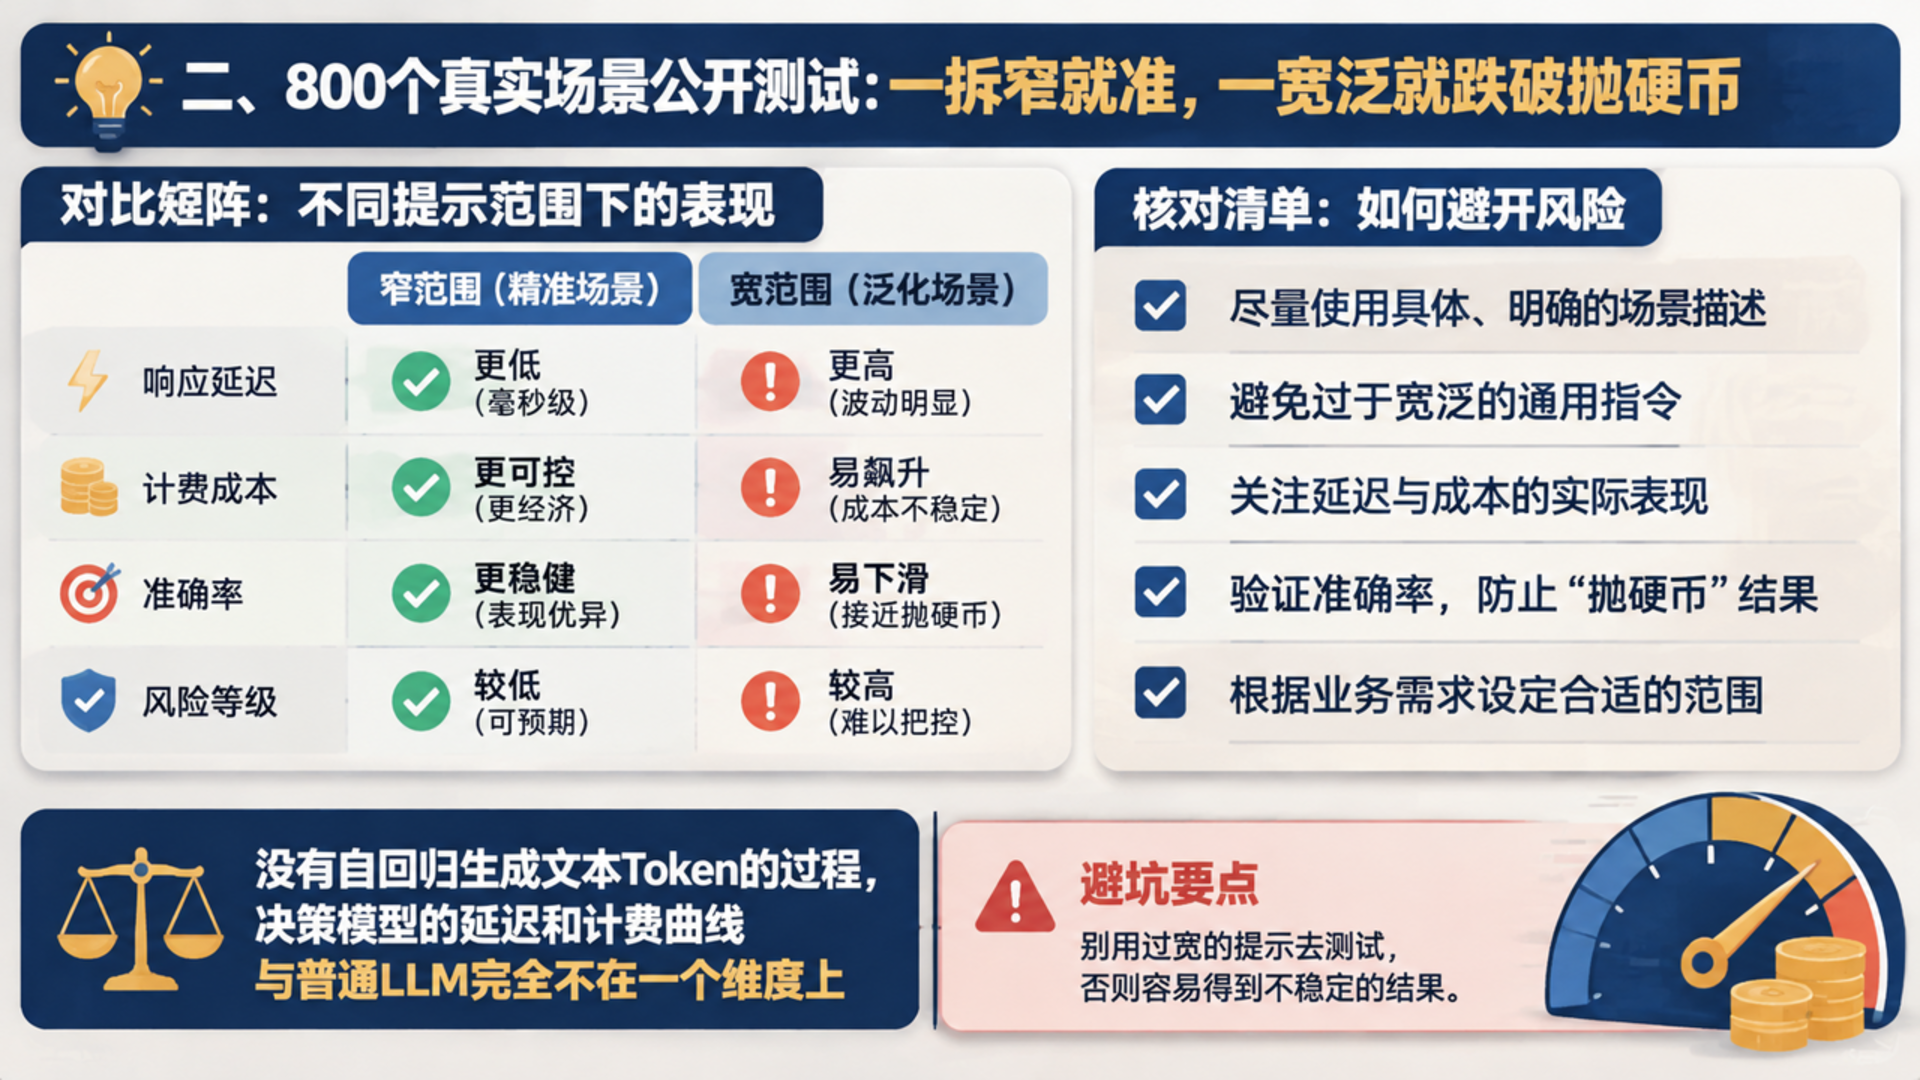
二、800个真实场景公开测试:一拆窄就准,一宽泛就跌破抛硬币
为了验证它能否真正替掉高延迟的LLM前置调用,作者整理了过往编码会话与公开数据集,构建了覆盖24个类别的800个真实场景。其中“模型路由”实验最直观地揭示了这类模型的使用诀窍:起初作者像问普通对话模型那样只提了一个宽泛主观问题(“根据这条Prompt,该交给小模型还是大模型处理?”),结果准确率只有 0.72,根本不敢上线;随后他把这个问题拆成4到5个具体可核查的小问题(例如:是否涉及鉴权或计费?是否仅仅是样式微调或文档更新?),准确率立刻跳升到 0.88。
| 评估场景类别 | 公开表现 / 准确率 | 响应延迟与成本参考 | 工程适配结论 |
| — | — | — | — |
| 客服工单分流路由 | 约 100% 准确 | 平均 230ms / 请求,$0.34 / 万次 | 极高契合:清晰分类边界立竿见影 |
| 提示词注入与文本劫持检测 | 99.7% 准确 | 前置快速拦截 | 极高契合:适合放在Agent入口作安全门卫 |
| 对话记忆留存过滤 | 88% 准确 | 显著低于每轮调用完整LLM | 较好契合:省去每轮昂贵的总结模型调用 |
| 模型大小路由(拆分4—5个窄问题) | 0.72 → 0.88 | 单次多问 ~250ms | 条件契合:必须拆分客观特征,禁问宽泛难题 |
| 大文件代码检索切片 | 表现不佳,普通代码胜出 | 确定性代码零模型成本 | 不建议使用:确定性规则逻辑更简单可靠 |
| 预测用户何时要手动纠偏打断 | 46% 准确(低于抛硬币) | — | 明确不适用:过度宽泛主观,单遍前向难以捕捉 |
在文章评论区,另一位独立研究者Tom Jones也补充了交叉印证数据:在539个编码任务上直接预测“便宜模型是否够用”,提示词嵌入的留出集AUC仅0.594,甚至不如11个表面长度特征;只有把便宜模型的初稿一并喂给路由器时AUC才升至0.64。这也从侧面说明,单靠原始Prompt做主观难度预测本身就是硬骨头。
三、AI可见度与生产系统该如何合理编排“快思考 + 慢思考”
结合这800个场景的成败规律,工程团队在搭建内容质检、GEO信源筛选或AI客服网关时,可以遵循一条清晰的“三层分工”法则:
- 确定性代码能算清的,坚决不进模型:文件切分、正则校验、字数统计、链接格式检查一律交给普通代码。
- 能拆解为窄布尔题的,交给System 1决策模型:例如多维度合规初筛、提示词注入防火墙、工单部门分类、记忆入库过滤,把100个原子检查打包进一次250ms请求里完成。
- 高度依赖全局语义和模糊权衡的,留给完整语言模型:跨段落事实推理、长文本改写与复杂规划任务,仍需依托具备深层语境理解能力的完整LLM。
常见问题(FAQ)
Q1:Gemini Decision 1为什么能做到无输出Token计费?
因为它不逐字生成自然语言文本,而是对输入进行单遍读取后直接输出布尔值、分数或分类标签,因此定价仅按输入Token($0.10 / 1M)计算。
Q2:用决策模型做LLM大小模型路由器时,为什么初始准确率只有0.72?
因为“该交小模型还是大模型”过于宽泛主观。只有拆解为是否涉计费/鉴权、是否纯文档或样式改动等4—5个具体客观小问题后,准确率才提升到0.88。
Q3:文章实验是否涵盖所有生产边界?
未完全涵盖。作者明确说明800个场景来自个人历史会话与公开数据集,尚未覆盖所有行业边缘场景,实际引入前仍需基于自有数据抽样校验。
本文依据Patrick Kelly(for Google AI)于2026年11月19日发布的《Exploring Decision Models, Part 1: Putting Gemini Decision 1 to the Test》整理,公开测试数据及评论区交叉验证口径均保留原文边界。
本文首发于 OpenLX文旅GEO·文旅AI信源基础设施(https://openlx.cn/),转载请注明出处与完整链接。