【核心摘要】 开发者
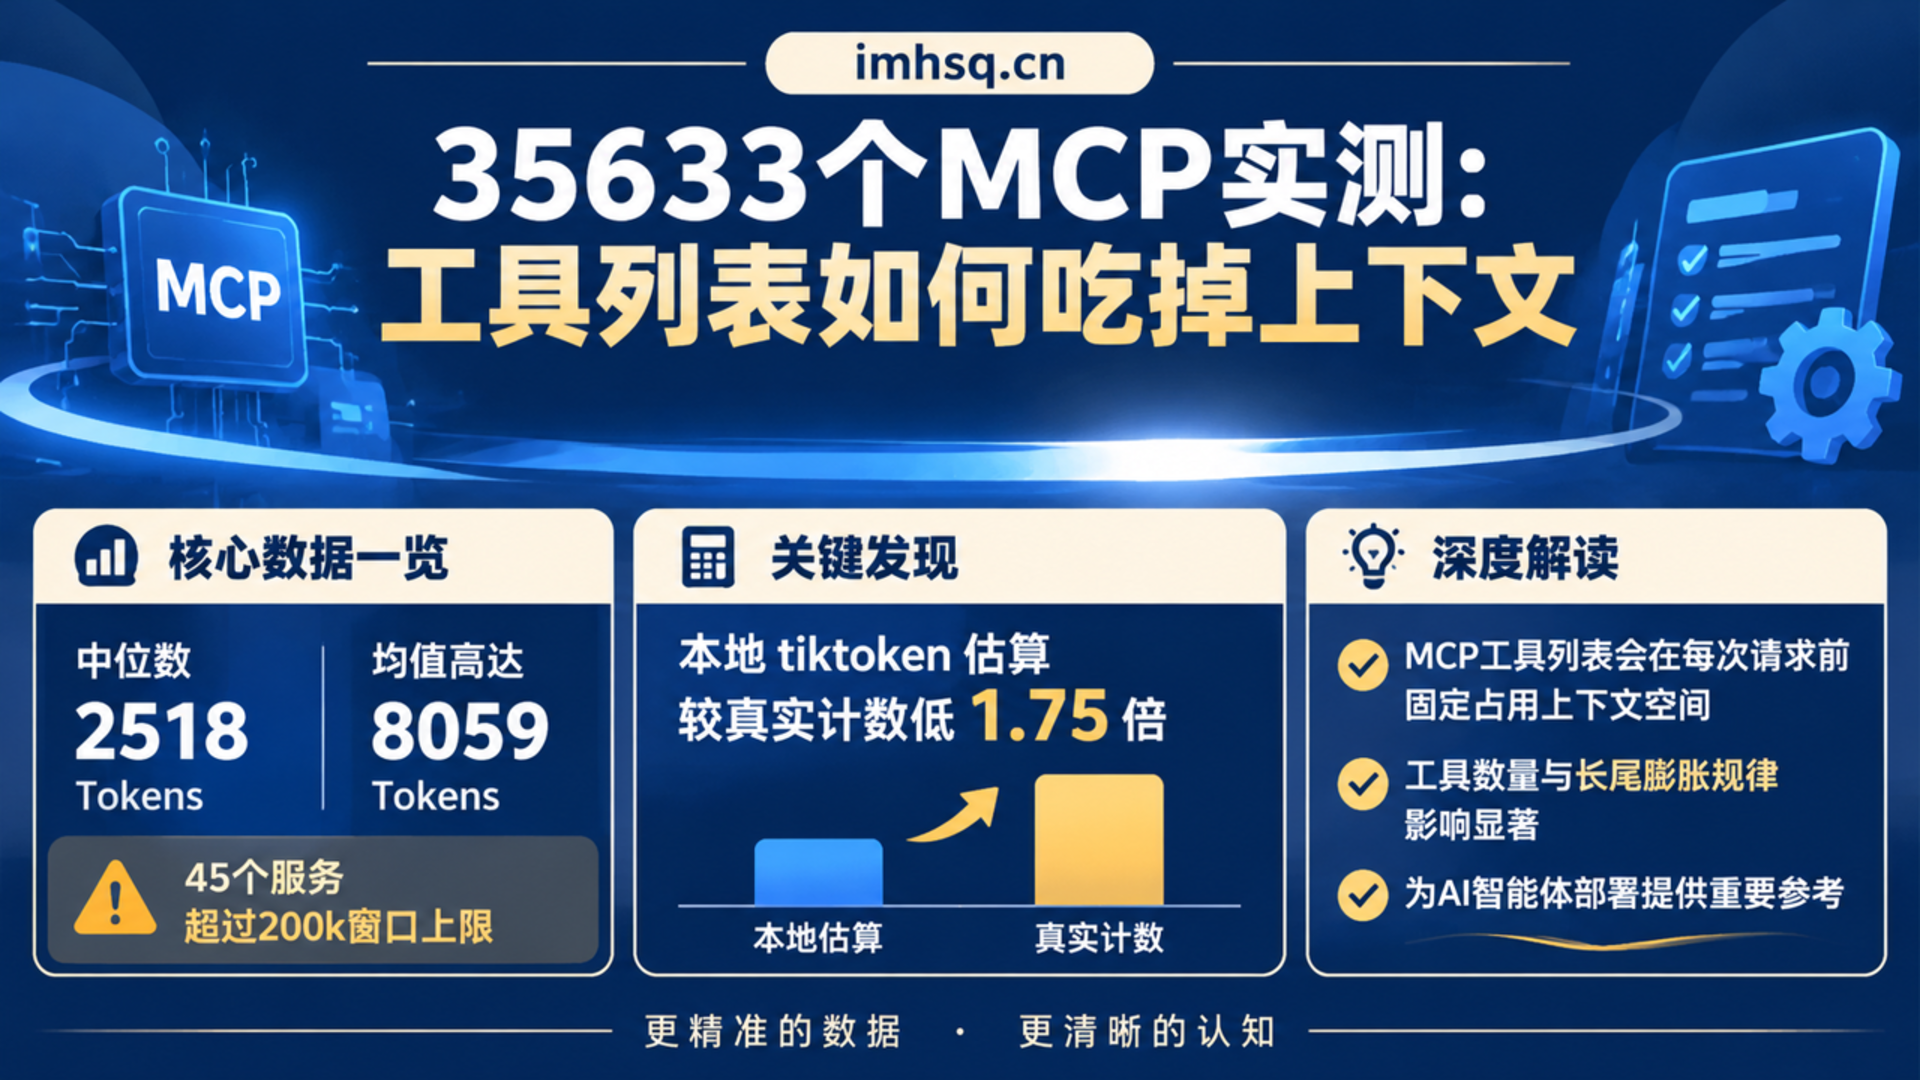
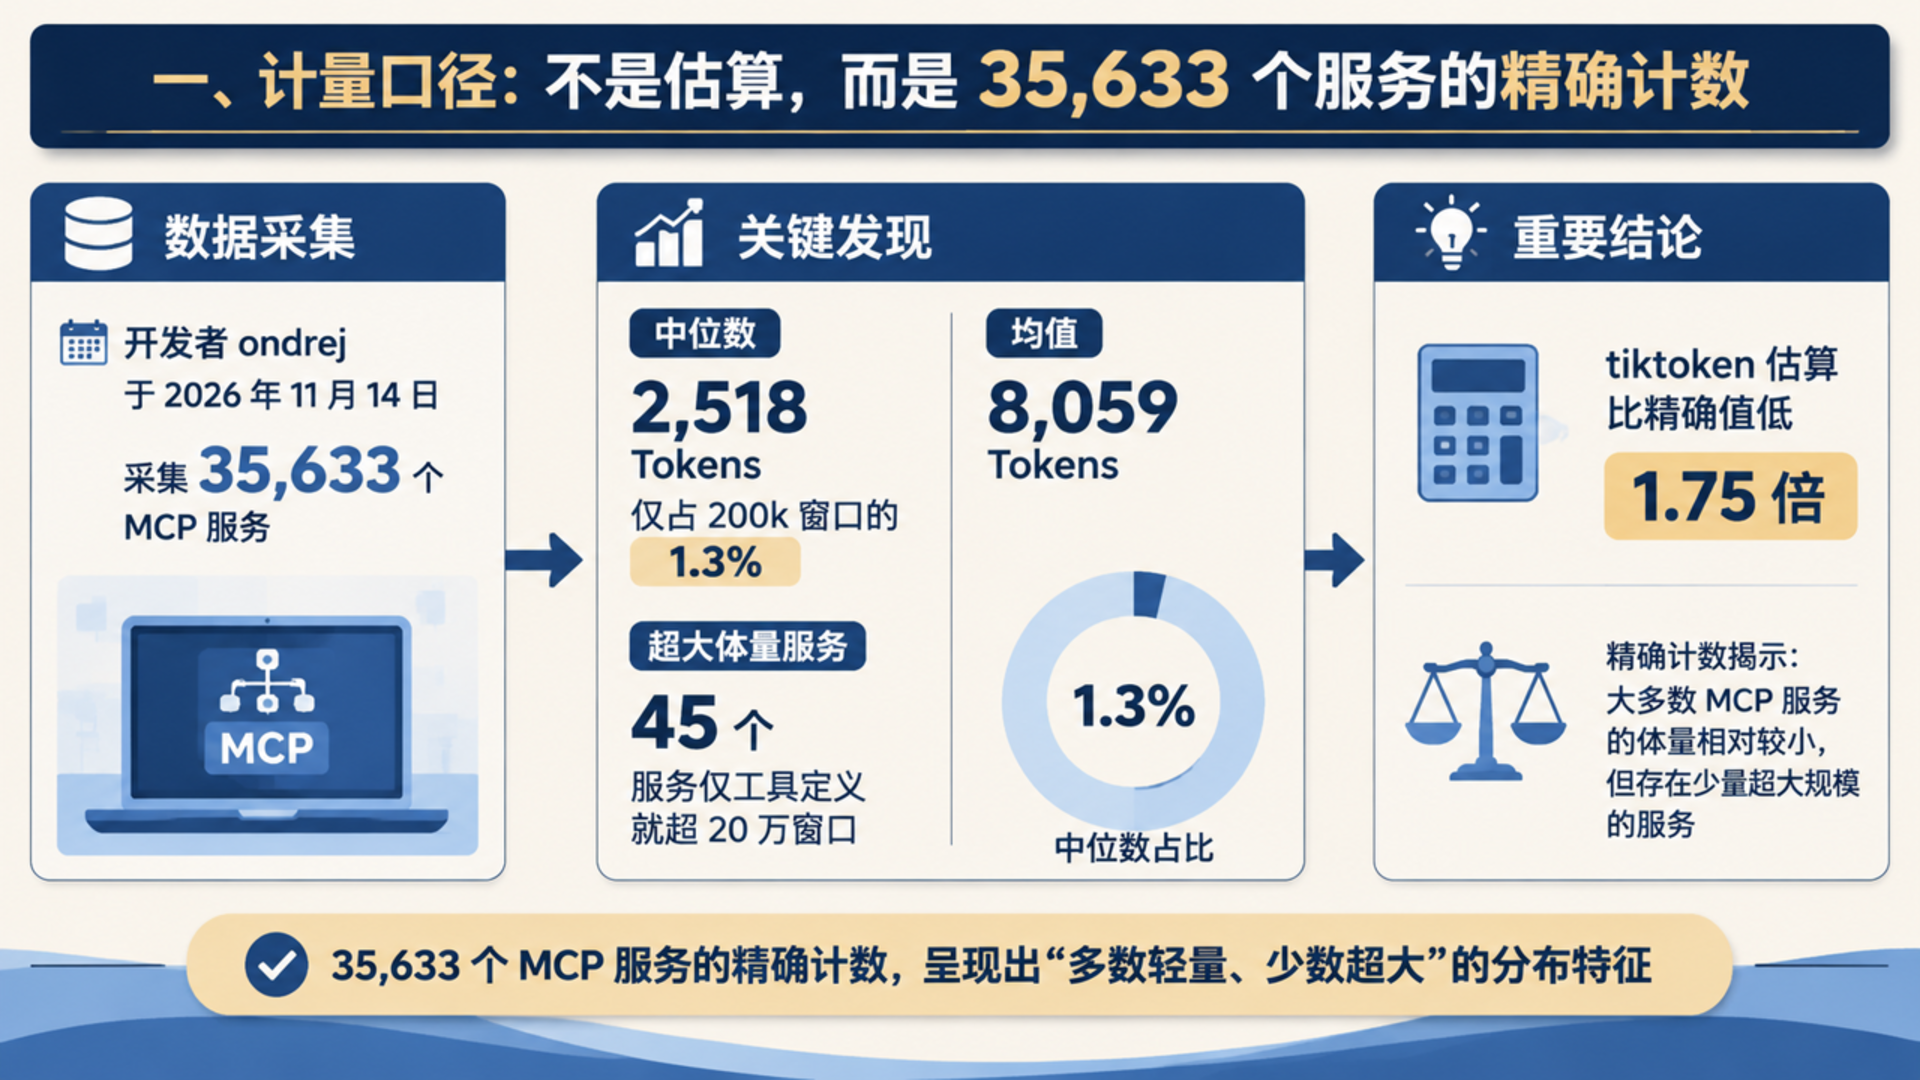
ondrej于 2026 年 11 月 14 日采集 35,633 个 MCP 服务并调用 Anthropiccount_tokens计量发现:中位数仅占 2,518 Tokens(200k 窗口的 1.3%),但均值被拉高至 8,059 Tokens,45 个服务仅工具定义就超 20 万窗口,且tiktoken估算比精确值低 1.75 倍。35633个MCP实测:工具列表如何吃掉上下文 知识卡片
在做大模型与智能体工程部署时,很多团队习惯只统计对话历史与知识库检索(RAG)的 Token 消耗,却忽略了一个在每次请求发出去之前就已经扣费的固定开销——MCP(Model Context Protocol)服务端挂载的工具定义列表。
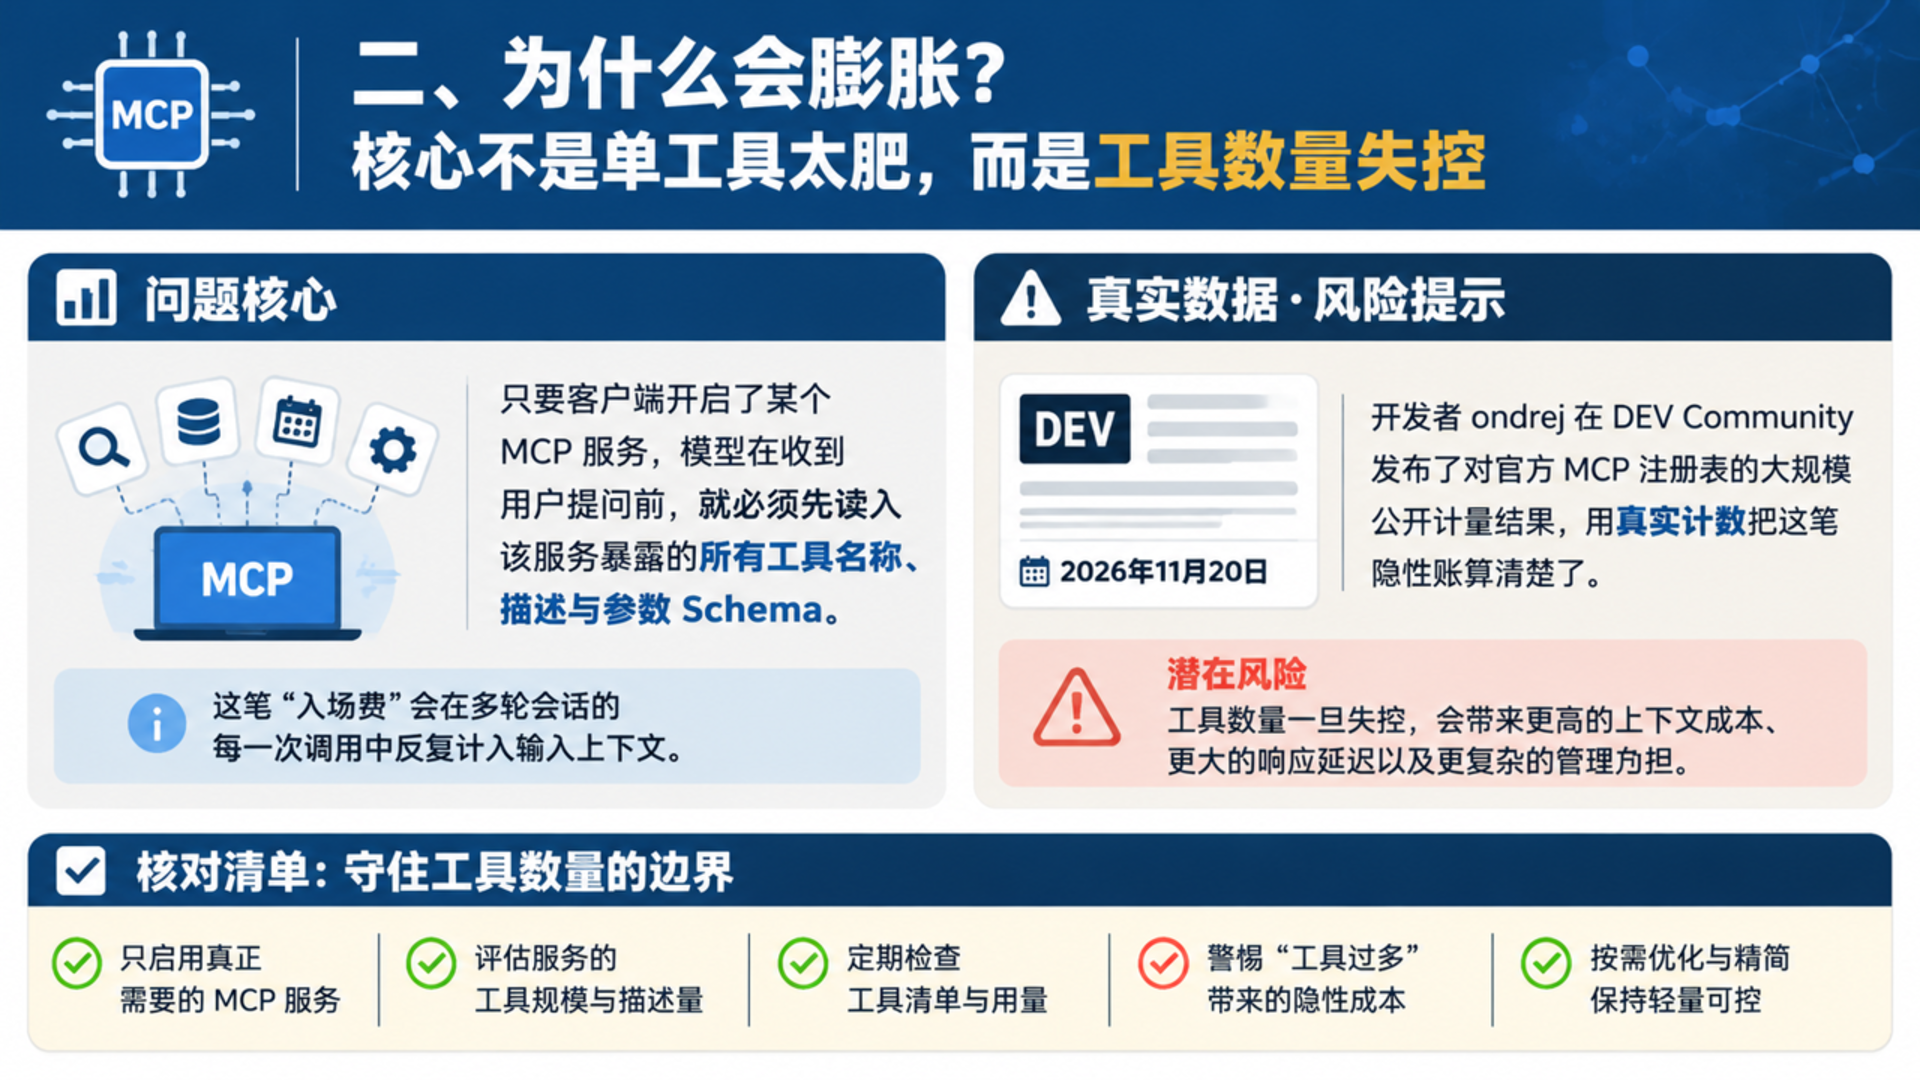
只要客户端开启了某个 MCP 服务,模型在收到用户提问前,就必须先读入该服务暴露的所有工具名称、描述与参数 Schema。这笔“入场费”会在多轮会话的每一次调用中反复计入输入上下文。近期,开发者 ondrej 在 DEV Community(2026 年 11 月 20 日发布)公布了对官方 MCP 注册表的大规模公开计量结果,用真实计数把这笔隐性账算清楚了。
一、计量口径:不是估算,而是 35,633 个服务的精确计数
这项采样依托作者每日运行的探测项目 mcpcost 完成:系统每日连接远程 MCP 服务并拉取 tools/list,打包型服务则每周在容器中拉起一次。为了避免本地分词器估算失真,作者在 2026 年 11 月 14 日 的采样中,直接调用 Anthropic 官方 count_tokens 端点,针对 Claude Opus 5.5 的计费口径,用“完整工具列表 + 微型标记工具”减去“仅标记工具”的差值,测得了 35,633 个有效服务 的真实输入 Token 数。
| 分位与统计指标 | 消耗 Token 数 | 200k 窗口参考对比 | 工程含义与观察结论 |
| :— | :—: | :—: | :— |
| 中位数(Median) | 2,518 | 1.3% | 一半以上服务包含 8 个及以下工具,同时挂载 5 个约占 6%(约 12,600 Tokens) |
| 均值(Average) | 8,059 | 约为中位数 3.2 倍 | 均值大幅高于中位数,被极少数超重服务端严重拉偏 |
| 第 90 分位(P90) | 17,043 | 5 个即超 40% | 10% 的服务单个超 1.7 万 Tokens;若并排挂载 5 个,未提问先占 40% 以上窗口 |
| 第 99 分位(P99) | 54,779 | Top 1% 占总量 16% | 头部 1%(356 个服务)共持有全注册表 16% 的工具定义 Token |
| 最大单个服务(Largest) | 1,633,624 | 相当于 8 个完整窗口 | 单个服务含 73 个工具、160 万+ Tokens,远超单窗口承载极限 |
更值得警惕的是“长尾越界”规模:在全部 35,633 个样本中,3,167 个服务超过 20,000 Tokens,133 个超过 100,000 Tokens,另有 45 个直接超过 200,000 Tokens——这意味着这 45 个服务甚至装不进它们原本打算运行的上下文窗口。
二、为什么会膨胀?核心不是单工具太肥,而是工具数量失控
很多开发者直观以为是 JSON Schema 写得太啰嗦,但 ondrej 将 35,633 个服务按“工具数量区间”拆表统计后发现,单工具平均体积其实非常稳定,中位数约 320 Tokens/工具,九成服务单工具低于 855 Tokens:
- 1–3 个工具(7,236 个服务):平均总消耗 872 Tokens,单工具约 425 Tokens;
- 4–10 个工具(13,932 个服务):平均总消耗 2,394 Tokens,单工具约 375 Tokens;
- 11–25 个工具(7,090 个服务):平均总消耗 6,577 Tokens,单工具约 402 Tokens;
- 26–50 个工具(5,941 个服务):平均总消耗 21,314 Tokens,单工具约 548 Tokens;
- 51–100 个工具(979 个服务):平均总消耗 33,160 Tokens,单工具约 520 Tokens;
- 100 个以上工具(455 个服务):平均总消耗 91,804 Tokens,单工具约 428 Tokens。
由此可以得到一条实用的工程经验法则:估算一个 MCP 服务的开销,先数清它暴露了多少个工具,再乘以 320。真正制造灾难的,往往不是单个接口描述太长,而是开发者图省事用 SDK 把后端几十上百个 API 原封不动映射成全量工具,外加少数极端个案(如 293 个服务单工具均价超 2,000 Tokens,最重的那一个均价高达 22,000 Tokens/工具)。
三、两个容易被团队忽略的工程盲区
从物理架构与工程观察的角度看,原文披露的两个细节对我们搭建 OpenLX 与法匠科技内部智能体工作流极具参考价值:
- 本地
o200k_base(tiktoken)压缩 JSON 估算系统性偏低 1.75 倍:作者先用紧凑 JSON 序列化配合o200k_base估算,再与count_tokens精确结果对照,发现真实开销的中位数是本地估算的 1.75 倍(八成样本落在 1.62 到 1.87 倍之间)。另外,像 Claude Code 这类客户端会将工具统一重命名为mcp<server><tool>,在中位数服务上还会额外增加约 3.5%(89 Tokens)。因此,只靠脚本里跑tiktoken觉得“很安全”,上线后账单和上下文水位依然可能翻倍。 - 报错口径不能混为一谈,且按需加载只是最坏情况的缓冲:作者坦承在 10 月份采集时,因 API Key 被计费端点拒绝,代码却把拒绝记录成了“服务端 Schema 被拒”,导致榜单连续 7 天误伤服务端。同理,在企业自建网关与监控中,鉴权失败与协议/Schema 校验失败必须严格分码记录。此外,作者特别提醒上述数据仅覆盖“无需鉴权即可列出工具”的服务(另有 13,140 个需认证服务未纳入,例如此前社区案例中 93 个工具占 55,000 Tokens 的 GitHub 官方服务),且现代客户端已逐步支持“按需加载工具定义”,但对于全量加载的 Agent 运行时而言,这份计量揭示的仍是不可回避的最坏开销上限。
四、给技术与运营负责人的精简落地清单
结合企业级 AI 智能体与独立站自动化系统的工程实践,在引入或发布 MCP 服务时,建议严格守住三条物理边界:
- 控制单服务工具粒度:8 个以内的高频核心工具是健康常态;一旦规划超过 40 个工具,必须经过架构审慎拆分或按角色权限分组,避免把整套后台 CRUD 接口一次性灌进大模型上下文。
- 拒绝用“平均值”评估性能:评估依赖组件和外部接口时,必须同时观测中位数(P50)与 90 分位(P90),防止少数长尾服务拖垮整体延迟与预算。
- 建立真实端到端计量与按需加载:不要仅凭紧凑 JSON 字符数拍脑袋估算,应使用目标模型原生计数接口做上线前基准校验,并优先采用按任务阶段延迟挂载工具的运行时策略。
五、常见问题(FAQ)
Q1:本次 35,633 个 MCP 服务的 Token 计量是如何确保结果准确的?
答:采样由 mcpcost 探测器采集工具列表后,直接调用 Anthropic 官方 count_tokens 接口(针对 Claude Opus 5.5)做“工具组+标记工具”与“仅标记工具”的差分计算,未采用本地分词器猜测,也未包含工具执行后的返回正文开销。
Q2:为什么本地用 tiktoken 算出来的 MCP 工具开销和线上实际差很多?
答:作者对照结果显示,count_tokens 的精确结果在八成服务中是 o200k_base 紧凑 JSON 估算值的 1.62 至 1.87 倍(中位数为 1.75 倍),主要源于模型后端对工具定义的结构化包装与前缀重命名开销。
Q3:企业自研 MCP 服务怎样避免“还没提问就吃光上下文”?
答:优先参考社区案例中的“收敛合并”思路(例如将 15 个零散工具收敛为 4 个组合工具),将单服务工具数控制在 8 个左右的合理区间,并对高复杂度场景启用按需加载或路由分组。
本文首发于 贺双全个人博客(https://imhsq.cn/),转载请注明出处与完整链接。